Vérifier une archive de sauvegarde de fichiers : de tar aux fichiers témoins
Une archive de fichiers a toujours l'air d'une sauvegarde réussie. Un nom, une date, une taille plausible. Ce qui décide si vous récupérez vos fichiers, c'est ce qu'on a écrit à côté de l'archive au moment de la produire, et le fait que quelqu'un l'ait déjà dépliée au moins une fois.
Ce guide monte la chaîne entière. À la fin, vous saurez ce qui tronque une archive sans le dire, comment produire une archive vérifiable avec sa somme de contrôle, comment écrire un script de sauvegarde qui ne peut pas annoncer un succès sur une archive vide, comment contrôler l'archive sans la déplier puis en l'extrayant pour de vrai, et pourquoi un simple comptage de fichiers ne prouve rien sans fichiers témoins.
Tout cela fonctionne avec tar, gzip, sha256sum et l'AWS CLI, et rien d'autre. La dernière section montre comment faire tourner ces mêmes vérifications sur une planification plutôt qu'à la main — c'est le travail de RestoreProof — mais la procédure tient debout seule, et le jour où ça compte, c'est elle que vous suivrez.
Ce qui casse une archive sans le dire
Une archive de fichiers a ceci de traître qu'elle ressemble toujours à une sauvegarde réussie : un fichier, une taille, une date. Voici ce qui se passe vraiment quand elle est cassée.
- Le disque était plein.
tarécrit jusqu'à la dernière page libre, puis s'arrête. Le fichier obtenu est une archive tronquée : ses premiers fichiers se déplient parfaitement, les derniers manquent, et aucune ligne de journal ne le dit si personne n'a lu le code de sortie. - La copie a été interrompue. Un transfert coupé vers le NAS ou vers S3 laisse un objet plus court que l'original. La liste des sauvegardes le montre avec la bonne date et le bon nom.
- Le code de sortie n'a pas été lu. C'est le cas le plus fréquent, et le plus facile à corriger : un
taren échec dans un script qui ne s'arrête pas sur l'erreur rend un succès au planificateur. - L'archive est chiffrée et personne n'a la clé. Elle est intacte, elle est récente, elle est illisible. Une clé de chiffrement qui n'est sauvegardée nulle part ailleurs que dans le serveur chiffré est une clé perdue.
Les trois premiers se détectent sans rien déplier, à condition d'avoir écrit à côté de l'archive de quoi les détecter. Le quatrième ne se détecte que par un déchiffrement réel, fait ailleurs que sur la machine d'origine.
Produire une archive qu'on peut vérifier
Deux commandes, pas une :
tar -czf /backups/app_data_20260918_010000.tar.gz -C /srv/app data config
sha256sum /backups/app_data_20260918_010000.tar.gz \
  > /backups/app_data_20260918_010000.tar.gz.sha256
-C /srv/app data config entre dans le répertoire avant d'archiver, et n'enregistre donc que les chemins data/ et config/. Sans -C, l'archive contient srv/app/data/... et se déplie dans une arborescence que personne n'attend.
La deuxième commande est celle qui change tout. Une somme de contrôle écrite à côté de l'archive, au moment où l'archive est produite, permet de répondre plus tard à une question qu'aucune inspection du fichier seul ne permet de trancher : ces octets sont-ils bien ceux qui ont été écrits ? Une archive tronquée ou une copie interrompue donnent un fichier qui s'ouvre partiellement, mais jamais la bonne empreinte.
Elle doit être calculée sur le serveur d'origine, avant le transfert. Une somme recalculée après la copie, sur la copie, ne prouve rien d'autre que la copie est égale à elle-même.
Une somme de contrôle n'est pas une signature
sha256sumdétecte une corruption accidentelle, pas une modification délibérée : qui peut réécrire l'archive peut réécrire le fichier.sha256posé à côté. Contre un rançongiciel, ce qui protège est ailleurs — un stockage que la machine sauvegardée ne peut pas effacer, versionné ou en écriture unique.
Le script de sauvegarde
#!/bin/bash
set -euo pipefail

ts=$(date +%Y%m%d_%H%M%S)
archive="/backups/app_data_${ts}.tar.gz"

tar -cf - -C /srv/app data config | gzip > "${archive}"
sha256sum "${archive}" > "${archive}.sha256"

aws s3 cp "${archive}" s3://sauvegardes-shopdemo/files/
aws s3 cp "${archive}.sha256" s3://sauvegardes-shopdemo/files/
Sans
pipefail, une archive ratée ressort en succèsDans
tar | gzip, le shell ne regarde que le code de sortie du dernier maillon.gzipréussit à compresser une sortie vide ou tronquée, donc le script rend 0 et le planificateur est content.set -o pipefail— inclus dans leset -euo pipefailci-dessus — fait échouer la ligne entière dès quetaréchoue. C'est la première cause de sauvegardes vides qui passent au vert pendant des mois.
L'horodatage dans le nom du fichier n'est pas une coquetterie : une archive toujours écrite au même nom ne laisse aucune chance de revenir à la veille, et une archive corrompue écrase la dernière bonne. Pour la rétention, une règle de cycle de vie sur le stockage supprime les objets de plus de N jours sans script à maintenir.
Deux précautions pour le lancement nocturne : que la sortie d'erreur aille quelque part où quelqu'un la lit, et qu'une exécution qui s'éternise n'en croise pas une autre — flock -n sur un fichier verrou règle le second point en une ligne.
Vérifier l'archive sans la déplier
Trois questions, de la moins chère à la plus chère, dans cet ordre :
cd /backups
sha256sum -c app_data_20260918_010000.tar.gz.sha256
gzip -t app_data_20260918_010000.tar.gz
tar -tzf app_data_20260918_010000.tar.gz | wc -l
- Les octets sont-ils les bons ?
sha256sum -crelit le fichier et compare à l'empreinte enregistrée. C'est la seule des trois qui attrape une copie silencieusement altérée. - Le flux compressé se lit-il jusqu'au bout ?
gzip -tdécompresse sans rien écrire et vérifie le contrôle de redondance quegzipplace à la fin du flux. Une archive tronquée échoue ici. - Le catalogue est-il cohérent ?
tar -tzfliste les en-têtes sans extraire un seul octet sur le disque. C'est aussi le moyen le plus rapide de voir ce que l'archive contient réellement à sa racine.
Extraire pour de vrai, dans un répertoire jetable
Lister n'est pas extraire. Les droits, les liens symboliques, les chemins inattendus ne se manifestent qu'à l'extraction.
essai=$(mktemp -d)
tar -xzf /backups/app_data_20260918_010000.tar.gz -C "${essai}"
Prenez le temps que ça a pris, et la place que ça a occupée. C'est votre durée de restauration réelle et votre besoin d'espace réel, les seuls chiffres à comparer à ce que vous avez promis.
Ce qu'on vérifie après extraction
find "${essai}" -type f | wc -l
du -sb "${essai}"
test -s "${essai}/config/app.yaml"
grep -q "database_url" "${essai}/config/app.yaml"
rm -rf "${essai}"
Les deux premières lignes donnent le volume : combien de fichiers, combien d'octets. Comparez à l'ordre de grandeur de la veille, pas à un chiffre exact. C'est ce qui attrape la sauvegarde qui rétrécit en silence — celle qui contient encore quarante fichiers au lieu de douze mille parce qu'un point de montage n'était pas monté au moment du tar.
Mais un comptage ne suffit pas, et il faut voir précisément pourquoi. Le nombre de fichiers et la taille totale sont des agrégats : ils ne savent pas de quels fichiers ils parlent. Une archive prise sur le mauvais répertoire, une arborescence où les données ont été remplacées par des fichiers de cache, un fichier de configuration tronqué à zéro octet au milieu de douze mille fichiers intacts — tout cela passe un seuil de volume sans broncher.
D'où les deux dernières lignes : les fichiers témoins. Un chemin que vous nommez, dont vous savez qu'il doit exister après l'extraction, et dont vous vérifiez qu'il contient quelque chose que vous reconnaissez. test -s refuse un fichier vide, grep -q refuse un fichier au bon nom dont le contenu n'est pas le bon. Choisissez-en deux ou trois : le fichier de configuration de l'application, un fichier de données au fond de l'arborescence, et le fichier le plus récemment écrit par la production.
Automatiser cette vérification
Ce qui précède coûte une heure, à chaque fois. C'est pour cette raison que ces vérifications, faites à la main, finissent par ne plus être faites.
RestoreProof rejoue exactement ces commandes en tâche planifiée, sur votre infrastructure : un runner récupère l'archive, la déplie dans un espace de travail jetable, pose les mêmes questions, détruit tout, et signe le résultat. Les données ne sortent pas de chez vous.
Déclarez d'abord l'archive comme source. Un partage NAS monté sur la machine du runner se déclare comme un dossier local : le chemin tel que le runner le voit, le motif app_data_*.tar.gz, et la stratégie le plus récemment modifié. Pour S3, ce sont le bucket et le préfixe ; les clés d'accès ne se saisissent pas, le plan porte une référence, env://AWS_ACCESS_KEY_ID, que le runner résout dans son propre environnement. Voir adapter le bloc fetch et les références de secrets.
Le modèle Archive Files écrit ensuite le plan, et ce plan est la manipulation que vous venez de faire à la main, ligne pour ligne :
| À la main | Dans le plan |
|---|---|
cp depuis le NAS, ou aws s3 cp | fetch, qui prend l'archive la plus récente |
tar -xzf dans un répertoire jetable | unpack, avec le format auto |
find | wc -l | RESTOREPROOF_CANARY_MIN_FILES |
du -sb | RESTOREPROOF_CANARY_MIN_TOTAL_SIZE |
test -s et grep -q | RESTOREPROOF_CANARY_FILES, avec min_size et contains |
sha256sum d'un fichier témoin | la clé expected_hash du même fichier témoin |
rm -rf du répertoire d'essai | le nettoyage, toujours exécuté |
Le seul ajout est max_age: 26h, et c'est celui qu'une extraction ne peut pas déduire du contenu : il fait échouer l'exécution quand l'archive la plus récente trouvée à la source est plus vieille que ce délai. Une sauvegarde qui a cessé d'être produite il y a trois mois se déplie parfaitement. Le plan complet, prêt à coller dans l'éditeur, est dans la recette fichiers et archives.
Les deux sondes du catalogue répondent à deux questions différentes, et le choix entre elles dépend de l'étape unpack :
filesystem-canaryregarde l'arborescence sortie de l'extraction. C'est elle qui porte les planchers de volume et les fichiers témoins, et c'est le seul moyen de prouver qu'un chemin nommé existe et contient ce qu'il doit contenir. Elle a besoin d'une étapeunpackavant elle. Sans aucun seuil ni chemin nommé, elle échoue exprès plutôt que de signer un vert vide.archive-integrityouvre l'archive de bout en bout sans rien restaurer, ce que faitgzip -t. Elle n'a de sens que dans un plan sans étapeunpack: dès qu'un plan déplie, l'extraction a déjà tout parcouru et une archive corrompue a déjà fait échouer l'étape. Son usage, c'est de confirmer qu'une archive reste ouvrable sans payer l'espace disque d'une extraction complète. Voir vérifier une archive sans la décompresser.
Les seuils ne se recopient pas depuis cette page. Un essai déplie votre archive, compte les fichiers et les octets qu'elle contient réellement, et propose chaque plancher 5 % sous la valeur mesurée, avec l'opérateur gte.
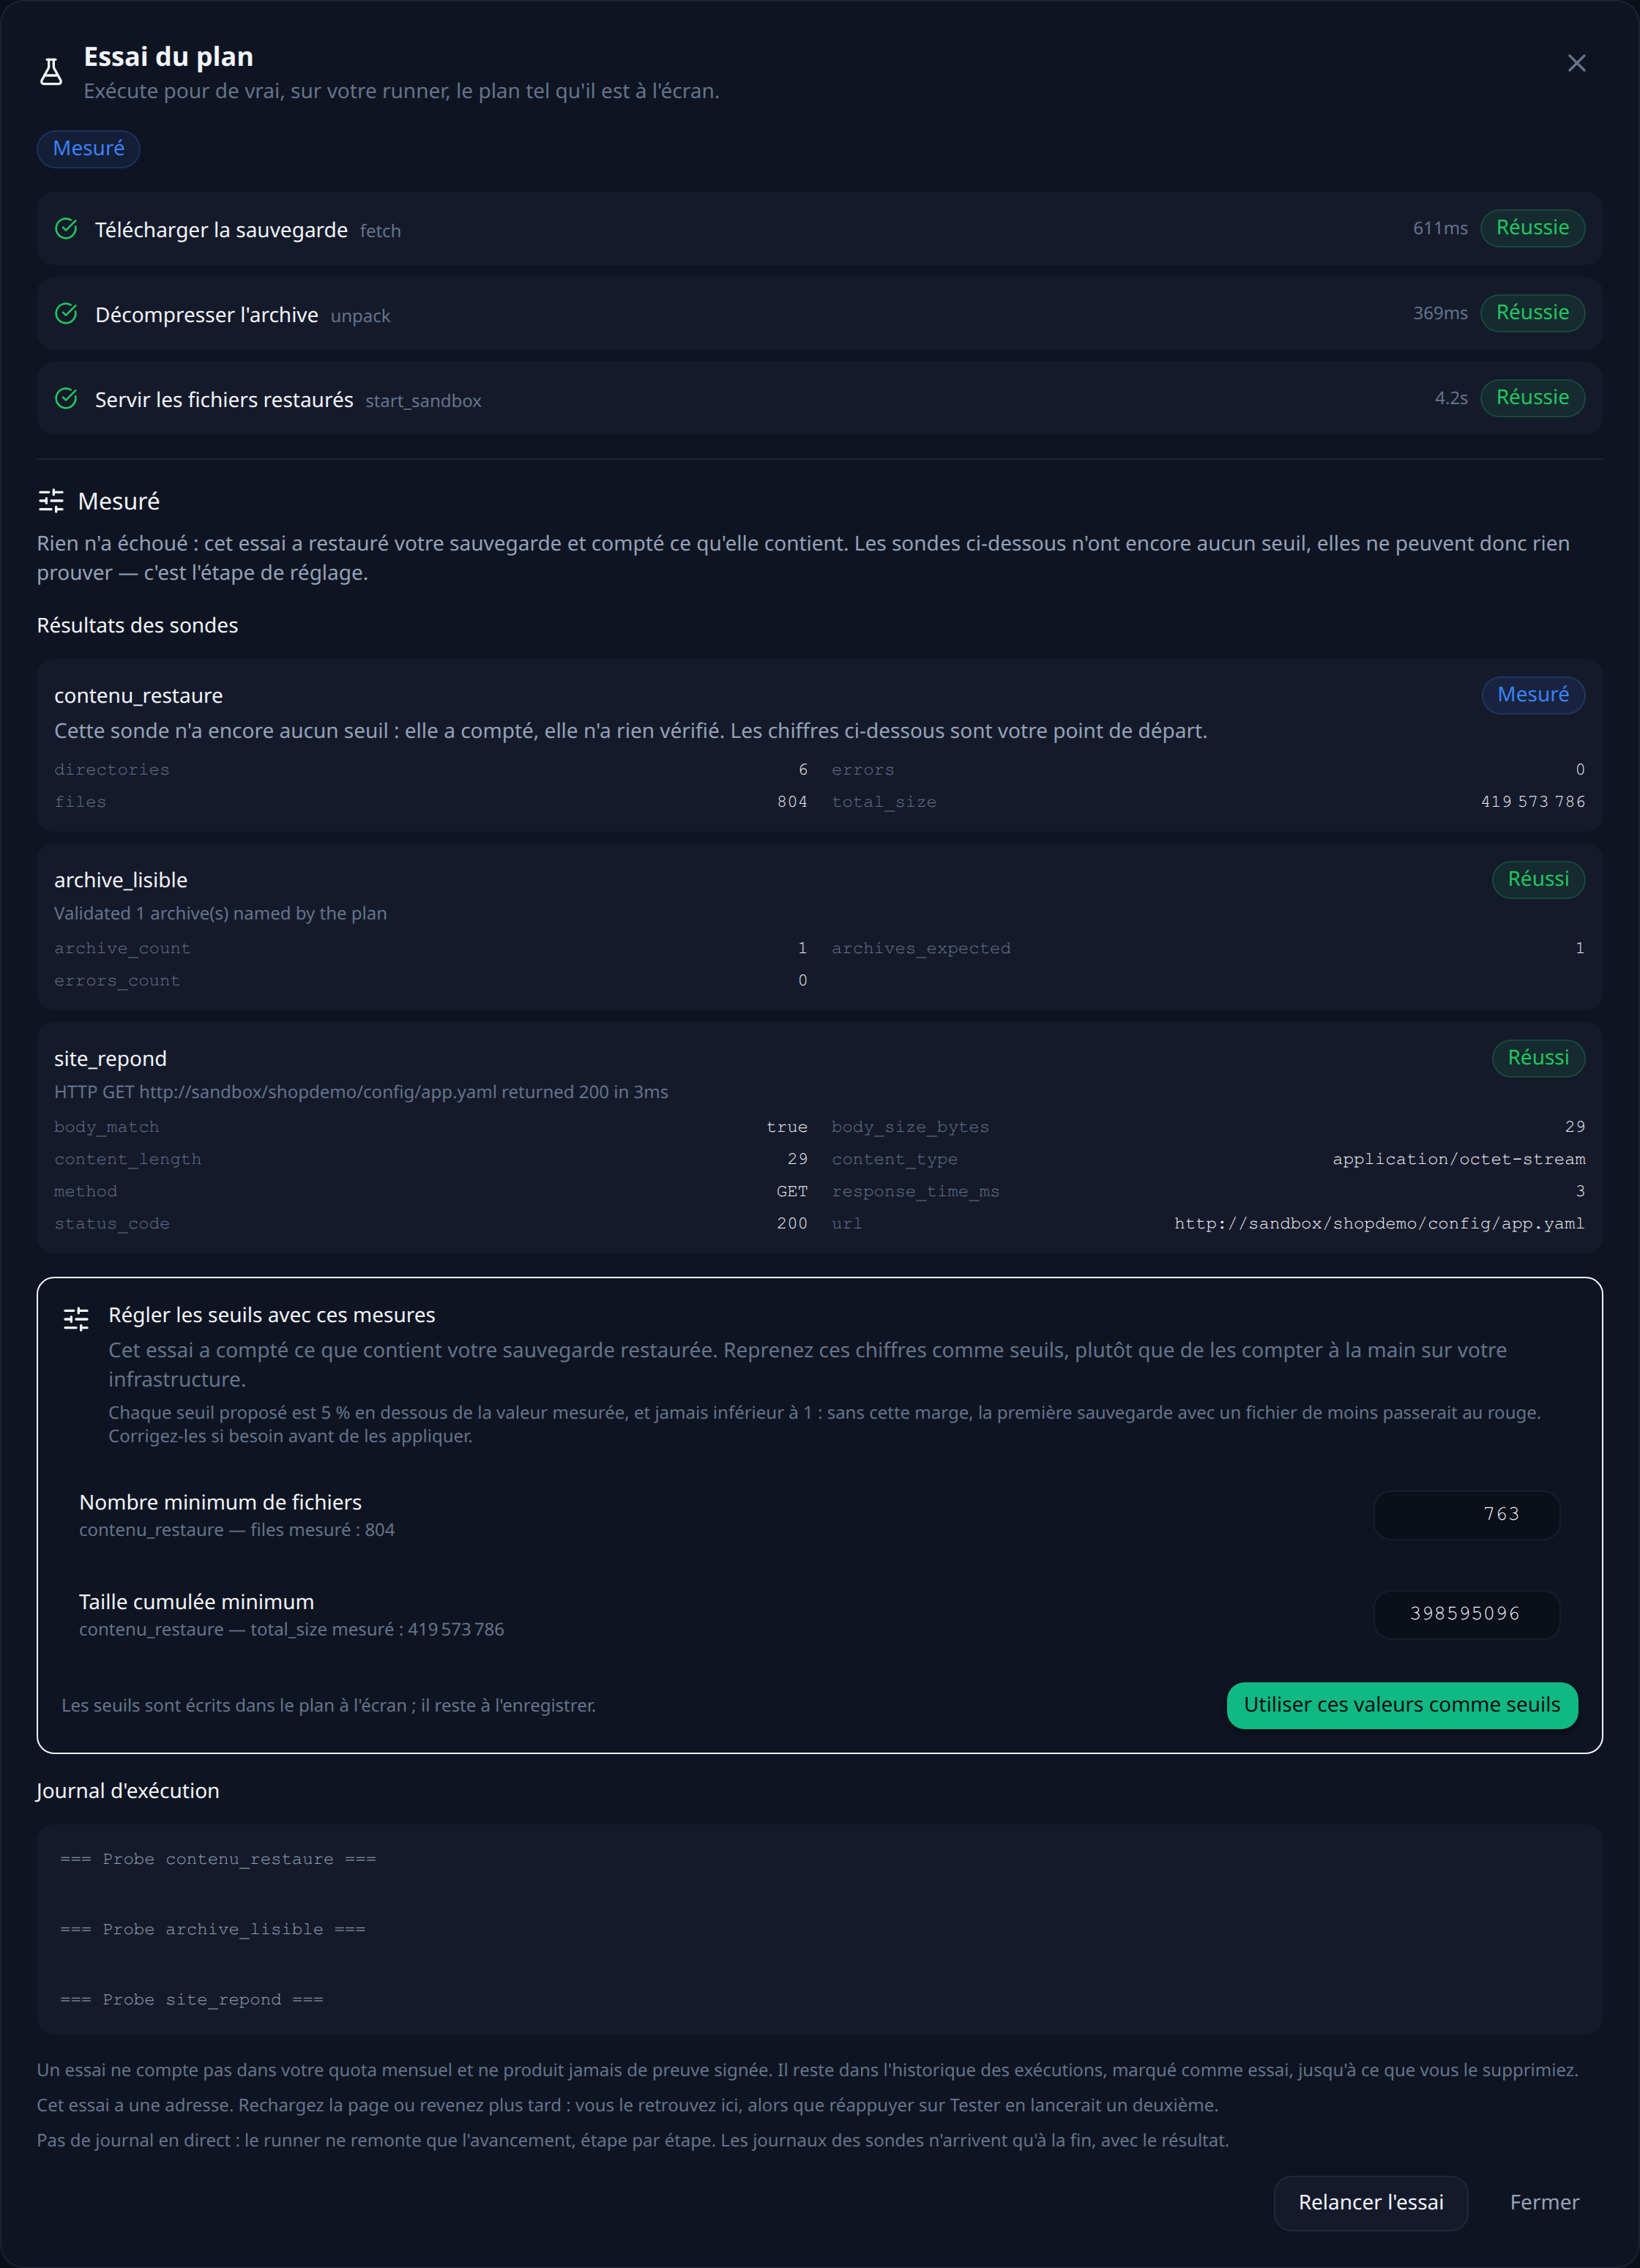
Ce que le comptage inclut
Le décompte de
filesystem-canaryporte sur tout l'espace de travail, y compris l'archive téléchargée qui s'y trouve encore, et les dossiers ne comptent pas comme des fichiers. Les chiffres proposés par l'essai en tiennent compte ; un chiffre compté à la main sur votre serveur, non.
Il reste à choisir une fréquence. Chaque nuit place l'exécution à 2 h du matin : votre script de sauvegarde tourne à 1 h, l'archive a donc une heure quand elle est éprouvée. L'autre déclenchement possible est un appel HTTP à la fin de ce script — la vérification porte alors exactement sur l'archive qui vient d'être produite.
Chaque exécution laisse un rapport horodaté, signé, qui nomme l'archive éprouvée et ce que chaque sonde a mesuré.
Ce que cette chaîne ne prouve pas
Elle prouve qu'une archive récente s'ouvre, se déplie entièrement, et que l'arborescence obtenue contient les fichiers que vous avez nommés avec le contenu que vous attendez. Elle ne prouve pas que votre application fonctionne sur ces fichiers : pour cela, il faut la démarrer contre l'arborescence restaurée et ajouter une sonde http. Elle ne dit rien des droits et des propriétaires d'origine, que tar n'enregistre que si vous le lui avez demandé et que l'extraction ne restitue que si elle tourne en root. Et elle ne dit rien de ce qui a été écrit depuis la dernière archive — cet écart, c'est votre RPO, et il se règle avec la fréquence des sauvegardes, pas avec les vérifications.
FAQ
Une sauvegarde de fichiers en vert ne suffit-elle pas ?
Elle dit que le job s'est terminé sans signaler d'erreur. Elle ne dit rien du fait que l'archive s'ouvre. Un tar | gzip sans pipefail rend un succès sur une archive tronquée. Un point de montage absent au moment du tar donne une archive parfaitement valide contenant quarante fichiers au lieu de douze mille. Seule une extraction, suivie d'un contrôle du contenu, distingue une archive qui existe d'une archive qui se restaure.
À quoi sert une somme de contrôle si l'archive s'ouvre déjà ?
À répondre à une question que l'ouverture ne tranche pas : ces octets sont-ils ceux qui ont été écrits ? Une copie interrompue vers le NAS ou vers S3 laisse un fichier plus court, qui se déplie partiellement sans erreur visible sur ses premiers fichiers. L'empreinte, calculée sur le serveur d'origine avant le transfert, est la seule chose qui attrape ce cas.
Comment détecter une archive qui a cessé d'être produite ?
Par son âge, pas par son contenu : une archive de mars se déplie parfaitement en septembre. Il faut donc une vérification qui échoue quand l'archive la plus récente trouvée à la source est plus vieille qu'un délai que vous fixez.
Pourquoi compter les fichiers ne suffit-il pas ?
Parce qu'un comptage est un agrégat : il ne sait pas de quels fichiers il parle. Une archive prise sur le mauvais répertoire, une arborescence où les données ont été remplacées par du cache, un fichier de configuration tronqué à zéro octet au milieu de milliers de fichiers intacts — tout cela passe un seuil de volume sans broncher. Un chemin nommé, dont on vérifie qu'il existe et qu'il contient un texte reconnaissable, ne passe pas.
Comment vérifier une archive chiffrée ?
En la déchiffrant ailleurs que sur la machine dont elle vient. Une archive chiffrée peut être intacte, récente et illisible : il suffit que la clé n'existe nulle part sauf sur le serveur sauvegardé. Ni la somme de contrôle ni l'ouverture du fichier ne voient ce cas — seul un déchiffrement réel, fait depuis une autre machine, le tranche.