Sauvegarder WordPress : la base, les fichiers, et la preuve que le site redémarre
La plupart des guides de sauvegarde WordPress s'arrêtent à une extension installée et à une case cochée. Le jour où ça compte, ce qui décide si votre site revient, c'est de savoir ce que la sauvegarde contient vraiment, et si quelqu'un a déjà rejoué les fichiers au moins une fois.
Un site WordPress vit à deux endroits : une base MySQL et un dossier wp-content. Une sauvegarde qui n'en prend qu'un ne restaure pas un demi-site, elle restaure un site cassé. Ce guide monte la chaîne entière : ce que les deux morceaux contiennent, ce qu'on peut laisser dehors, ce que wp-config.php implique, le script qui produit les deux fichiers et les envoie sur S3, la restauration faite à la main jusqu'au site qui répond, et les requêtes qui disent qu'une base restaurée contient réellement vos articles.
Tout cela fonctionne avec mysqldump, tar, docker et l'AWS CLI, et rien d'autre. La dernière section montre comment faire tourner cette même restauration et ces mêmes vérifications sur une planification plutôt qu'à la main — c'est le travail de RestoreProof — mais la procédure tient debout seule, et le jour où ça compte, c'est elle que vous suivrez.
Une sauvegarde WordPress, c'est deux choses
WordPress range ses données à deux endroits, et une sauvegarde qui n'en prend qu'un ne restaure rien d'utilisable.
- La base MySQL contient les articles, les pages, les commentaires, les comptes, les réglages du site et la configuration de chaque extension.
wp-contentcontient les médias téléversés (uploads), les thèmes et les extensions.
Avec la base seule, chaque article référence des images qui n'existent plus et le thème actif est introuvable : WordPress démarre, mais sur un site vide de sa présentation. Avec wp-content seul, vous avez des fichiers que rien ne rattache à un article ou à un auteur. Il faut les deux, et il faut savoir que les deux sont là.
Ce qu'on peut laisser dehors :
- le cœur de WordPress —
wp-admin,wp-includeset les fichiers PHP de la racine. C'est un téléchargement public : on le récupère à la version qu'on veut, et il n'apporte rien à l'archive ; - les caches —
wp-content/cacheet les fichiers produits par une extension d'optimisation. Ils se régénèrent, et ils grossissent l'archive sans rien ajouter à la preuve.
Reste wp-config.php, qui n'est ni le cœur ni vos données.
Le cas de wp-config.php
Ce fichier contient deux choses de nature différente.
- Les identifiants de la base :
DB_NAME,DB_USER,DB_PASSWORD,DB_HOST. Ils ne valent que pour le serveur où le fichier vit, et vous les avez normalement ailleurs. - Les clés de salage :
AUTH_KEY,SECURE_AUTH_KEY,NONCE_SALTet leurs voisines. Elles signent les cookies de session. Les perdre déconnecte tout le monde une fois, et c'est tout ; les regénérer est une opération normale.
Le sauvegarder vous épargne une demi-heure le jour de la restauration, et met le mot de passe de votre base de production dans une archive qui part sur un stockage distant. Le laisser dehors vous oblige à réécrire quatre lignes, et c'est le choix à préférer si l'archive quitte votre réseau. Dans les deux cas, gardez une trace de la version de WordPress et de la liste des extensions actives : c'est ce qui manque le plus souvent le jour où on restaure.
Le script de sauvegarde
Deux fichiers, produits côte à côte : le dump de la base et l'archive de wp-content.
#!/bin/bash
set -euo pipefail

ts=$(date +%Y%m%d_%H%M%S)
dest=s3://sauvegardes-monsite/wordpress

mysqldump -h db.interne -u wordpress --single-transaction --routines --triggers \
  wordpress | gzip > "/backups/wordpress_${ts}.sql.gz"

tar -czf "/backups/.wp-content_${ts}.tar.gz" -C /var/www/html wp-content
mv "/backups/.wp-content_${ts}.tar.gz" "/backups/wp-content_${ts}.tar.gz"

aws s3 cp "/backups/wordpress_${ts}.sql.gz" "${dest}/mysql/"
aws s3 cp "/backups/wp-content_${ts}.tar.gz" "${dest}/files/"
--single-transaction prend le dump dans une transaction unique : les tables InnoDB de WordPress sortent cohérentes entre elles sans que le site soit verrouillé pendant l'opération. --routines --triggers ajoute ce que mysqldump laisse dehors par défaut.
Le mot de passe n'est pas sur la ligne de commande : il est lu dans la variable MYSQL_PWD ou dans un fichier ~/.my.cnf. Un mot de passe passé en argument est visible dans la liste des processus de la machine, pour tout le monde.
Sans
pipefail, un dump raté ressort en succèsDans
mysqldump | gzip, le shell ne regarde que le code de sortie du dernier maillon.gzipréussit très bien à compresser une sortie vide, donc le script rend 0 et le cron est content.set -o pipefail— inclus dans leset -euo pipefailci-dessus — fait échouer la ligne entière dès quemysqldumpéchoue. C'est la première cause de sauvegardes vides qui passent au vert pendant des mois.
L'archive est écrite sous un nom caché, puis renommée. Ce n'est pas de la coquetterie : pendant les minutes que dure le tar, le fichier est déjà le plus récent du répertoire, et quiconque lit « la sauvegarde la plus récente » lit une archive tronquée. Le mv est atomique, donc le fichier apparaît sous son nom définitif seulement quand il est complet.
Gardez l'horodatage dans les deux noms, et gardez les deux morceaux séparés : ils se restaurent séparément, et une archive unique qui contient tout oblige à tout déplier pour vérifier une moitié. Pour la rétention, une règle de cycle de vie sur le bucket supprime les objets de plus de N jours sans script à maintenir.
Restaurer une fois, à la main
Une sauvegarde n'est prouvée que restaurée. Faites-le une fois, entièrement, sur un poste jetable — c'est aussi la procédure que vous suivrez le jour où ça compte.
D'abord la base, dans un MySQL neuf :
docker network create wp-essai

docker run -d --name wp-db --network wp-essai \
  -e MYSQL_ROOT_PASSWORD=essai -e MYSQL_DATABASE=wordpress mysql:8.0
until docker exec wp-db mysqladmin ping -h 127.0.0.1 -u root -pessai --silent; do sleep 2; done

gunzip -c /backups/wordpress_20260918_010000.sql.gz \
  | docker exec -i wp-db mysql -u root -pessai wordpress
Un dump d'une seule base ne crée pas la base
mysqldump wordpress, comme ci-dessus, ne contient niCREATE DATABASEniUSE: la base doit exister avant, et être nommée sur la ligne de commande du client. C'est le rôle duMYSQL_DATABASE=wordpresset duwordpressfinal. Avecmysqldump --databases wordpress, le dump porte ses propresCREATE DATABASEetUSE, et se rejoue sans nommer de base.
Puis les fichiers, et un WordPress démarré dessus :
mkdir -p /essai
tar -xzf /backups/wp-content_20260918_010000.tar.gz -C /essai

docker run -d --name wp-site --network wp-essai -p 8080:80 \
  -e WORDPRESS_DB_HOST=wp-db \
  -e WORDPRESS_DB_NAME=wordpress \
  -e WORDPRESS_DB_USER=root \
  -e WORDPRESS_DB_PASSWORD=essai \
  -v /essai/wp-content:/var/www/html/wp-content \
  wordpress:6-apache
Le conteneur installe le cœur de WordPress lui-même : c'est la démonstration qu'il n'avait pas à être dans la sauvegarde. Seul wp-content vient de votre archive, et la base vient de votre dump.
Reste à demander au site s'il répond :
until curl -sf -o /dev/null http://localhost:8080/; do sleep 2; done
curl -s http://localhost:8080/wp-json/wp/v2/posts | head -c 400
Le code 200 sur la page d'accueil prouve seulement que le conteneur a démarré : une installation neuve répond 200 elle aussi. Ce qui compte, c'est qu'un de vos articles revienne par l'API REST — là, toute la chaîne est prouvée d'un coup : le dump, la base, l'application, le HTTP.
Prenez le temps que ça a pris. C'est votre durée de restauration réelle, la seule à comparer au délai que vous avez promis. Puis détruisez tout : docker rm -f wp-site wp-db et docker network rm wp-essai.
Ce qu'on vérifie dans une base restaurée
Le dump s'est rejoué sans erreur ne veut pas dire que vos données sont là. Quatre questions, dans cet ordre :
select count(*) from wp_users;
select count(*) from wp_posts where post_status = 'publish' and post_type = 'post';
select count(*) from wp_options where option_name in ('siteurl', 'home') and option_value <> '';
select max(post_date) from wp_posts where post_status = 'publish';
- Un compte peut encore se connecter. Zéro ligne dans
wp_users, c'est un site restauré que personne n'administre. - Les articles publiés sont revenus. C'est le nombre qui distingue un site restauré d'une installation neuve : une installation neuve a déjà toutes ses tables
wp_, et aucun de vos articles. - Le site a une adresse.
siteurlethomedoivent être présentes et non vides, donc deux lignes exactement. Sans elles, WordPress sert un site que personne n'atteint, aussi complète que soit la restauration. - La donnée est récente. La date du dernier article publié doit ressembler à celle que vous attendez, pas à celle du mois dernier. C'est ce qui attrape une sauvegarde qui a cessé d'être produite.
wp_ est un défaut, pas une règle : un site qui a changé son préfixe a besoin du sien dans les quatre requêtes, sinon elles interrogent des tables qui n'existent pas. Voir le préfixe des tables.
Côté fichiers, trois repères et un volume :
ls -d /essai/wp-content/themes /essai/wp-content/plugins /essai/wp-content/uploads
find /essai/wp-content/uploads -type f | wc -l
du -sh /essai/wp-content/uploads
Une arborescence parfaitement formée avec un uploads vide est le résultat habituel d'un tar sur un chemin exclu, ou d'un montage absent au moment de la sauvegarde. Le nombre de fichiers et la taille totale sont ce qui le voit ; comparez-les à l'ordre de grandeur de la production, pas à un chiffre exact.
Enfin, un média témoin, demandé au site restauré plutôt que lu sur le disque — prenez l'adresse d'une image de votre article le plus récent :
curl -sS -o /dev/null -w '%{http_code}\n' \
  http://localhost:8080/wp-content/uploads/2026/09/photo.jpg
Un 404 ici, avec une base pleine et un site qui répond, c'est exactement le cas que la moitié des sauvegardes WordPress ne voit jamais.
Automatiser cette vérification
Ce qui précède coûte une heure ou deux, à chaque fois. C'est pour cette raison que ces tests, faits à la main, finissent par ne plus être faits.
RestoreProof rejoue ces étapes en tâche planifiée, sur votre infrastructure : un runner récupère la sauvegarde, la restaure dans un conteneur jetable, pose les mêmes questions que ci-dessus, détruit tout, et signe le résultat. Les données ne sortent pas de chez vous.
Déclarez d'abord deux sources — le dump et l'archive n'ont ni le même préfixe ni le même motif de fichier : wordpress_*.sql.gz d'un côté, wp-content_*.tar.gz de l'autre, avec la stratégie le plus récemment modifié sur les deux. Les clés d'accès ne se saisissent pas : le plan porte une référence, env://AWS_ACCESS_KEY_ID, que le runner résout dans son propre environnement. Voir les références de secrets.
La base et les fichiers font ensuite deux plans, pas un. Un plan rouge vous dit alors lequel des deux morceaux est en cause sans que vous ayez à lire un journal, et les deux ne répondent pas à la même question : le premier dit « ma base est restaurable », le second dit « mes médias sont là ». C'est la forme que prennent toutes les applications qui se sauvegardent en deux morceaux, décrite dans la recette des applications auto-hébergées.
Ensemble, ces deux plans sont la manipulation que vous venez de faire à la main, ligne pour ligne :
| À la main | Dans le plan |
|---|---|
aws s3 cp du dump depuis le bucket | fetch, qui prend le fichier le plus récent |
gunzip -c | unpack, au format gzip |
docker run mysql:8.0 | start_sandbox |
mysql -u root … wordpress | restore_mysql, avec database: wordpress |
| les quatre requêtes | une sonde mysql par question |
tar -xzf de l'archive | unpack, au format tar.gz, dans le second plan |
ls des trois répertoires | une sonde filesystem-canary |
docker rm -f | le nettoyage, toujours exécuté |
Aller jusqu'au site qui répond demande un pas de plus : un second bac à sable qui démarre WordPress sur la base restaurée, et une sonde http qui interroge son API REST. Les deux bacs à sable portent les alias sandbox et sandbox-2 dans l'ordre où ils apparaissent dans le plan. C'est décrit dans aller jusqu'au site qui répond.
Le seul ajout est max_age, sur les deux sources, et c'est la seule vérification qu'une restauration ne peut pas déduire du contenu : elle fait échouer l'exécution quand le fichier le plus récent trouvé à la source est plus vieux que le délai donné. 26h laisse passer une sauvegarde nocturne, et refuse une sauvegarde qui a manqué une nuit.
La version du bac à sable
mysql:8.0doit reprendre la version majeure de votre serveur. Un dump pris sur un serveur plus récent ne se rejoue pas toujours sur un serveur plus ancien. Pour un site hébergé sur MariaDB, le bac à sable est une imagemariadb, et le reste du plan ne change pas.
Les seuils ne se recopient pas depuis cette page. Un essai restaure votre sauvegarde, compte ce qu'elle contient réellement, et propose chaque seuil sous la valeur mesurée. Voir les seuils ne se comptent pas à la main.
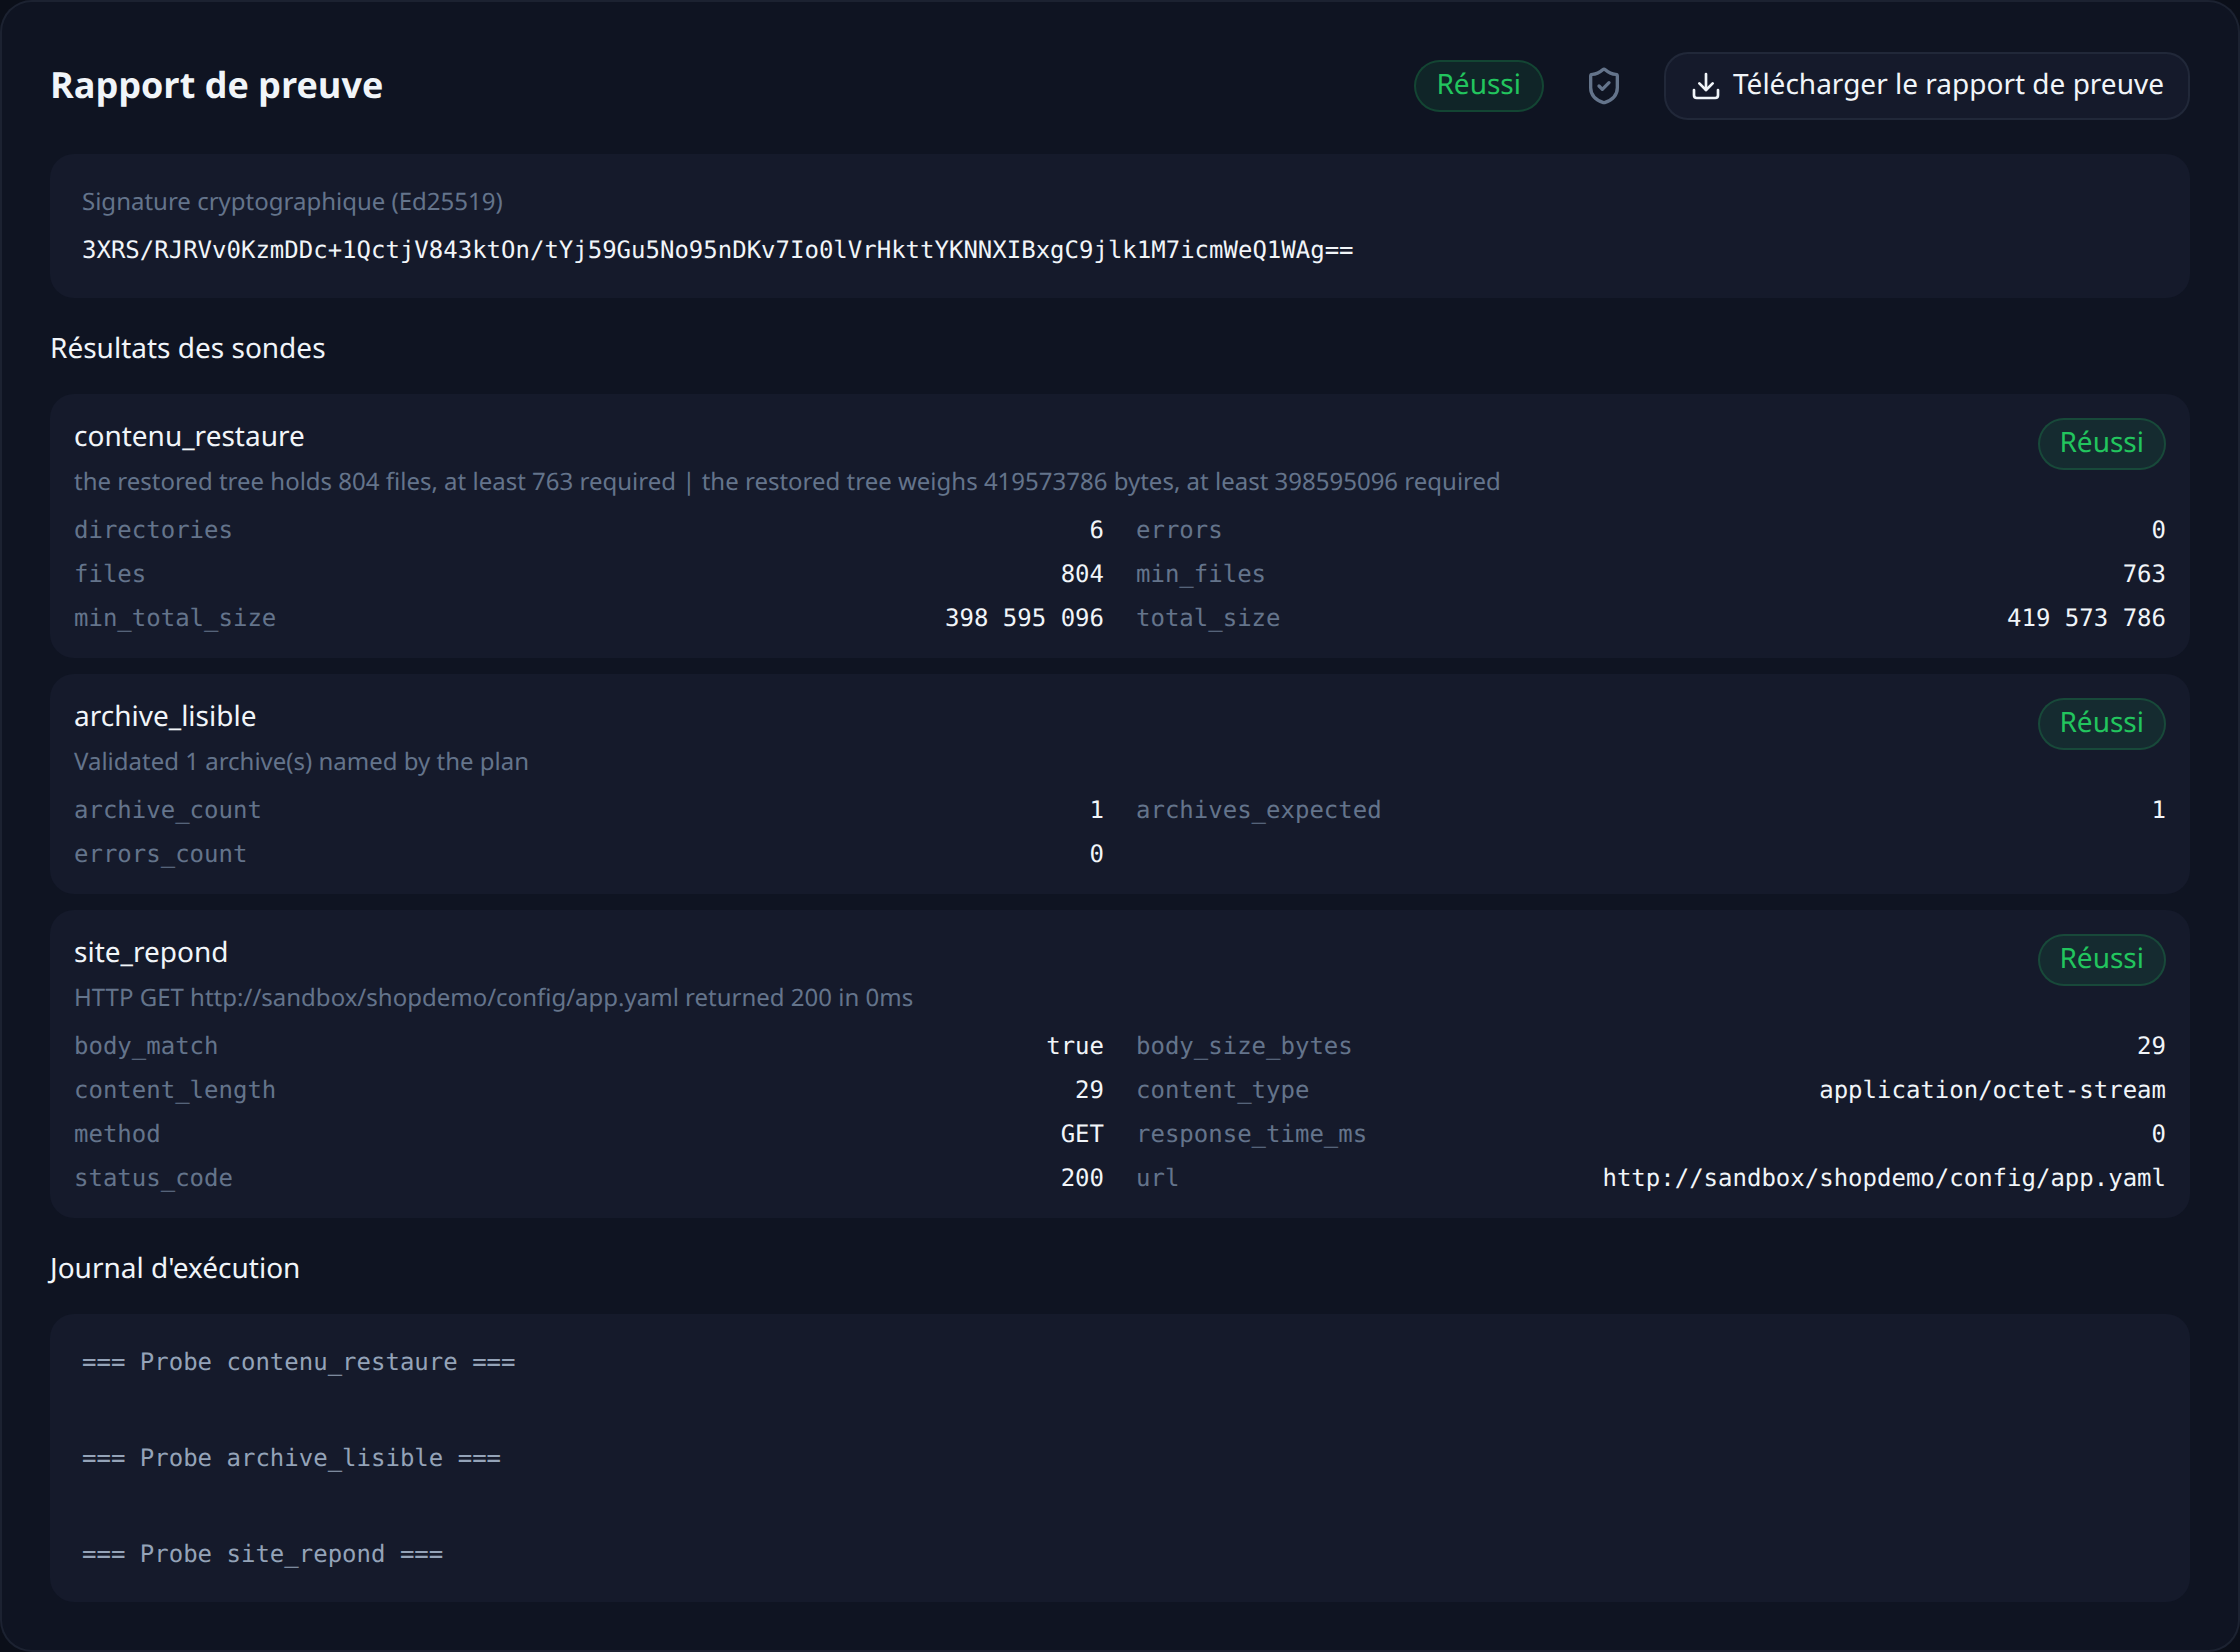
Chaque exécution laisse un rapport horodaté, signé, qui nomme la sauvegarde éprouvée et ce que chaque sonde a mesuré.
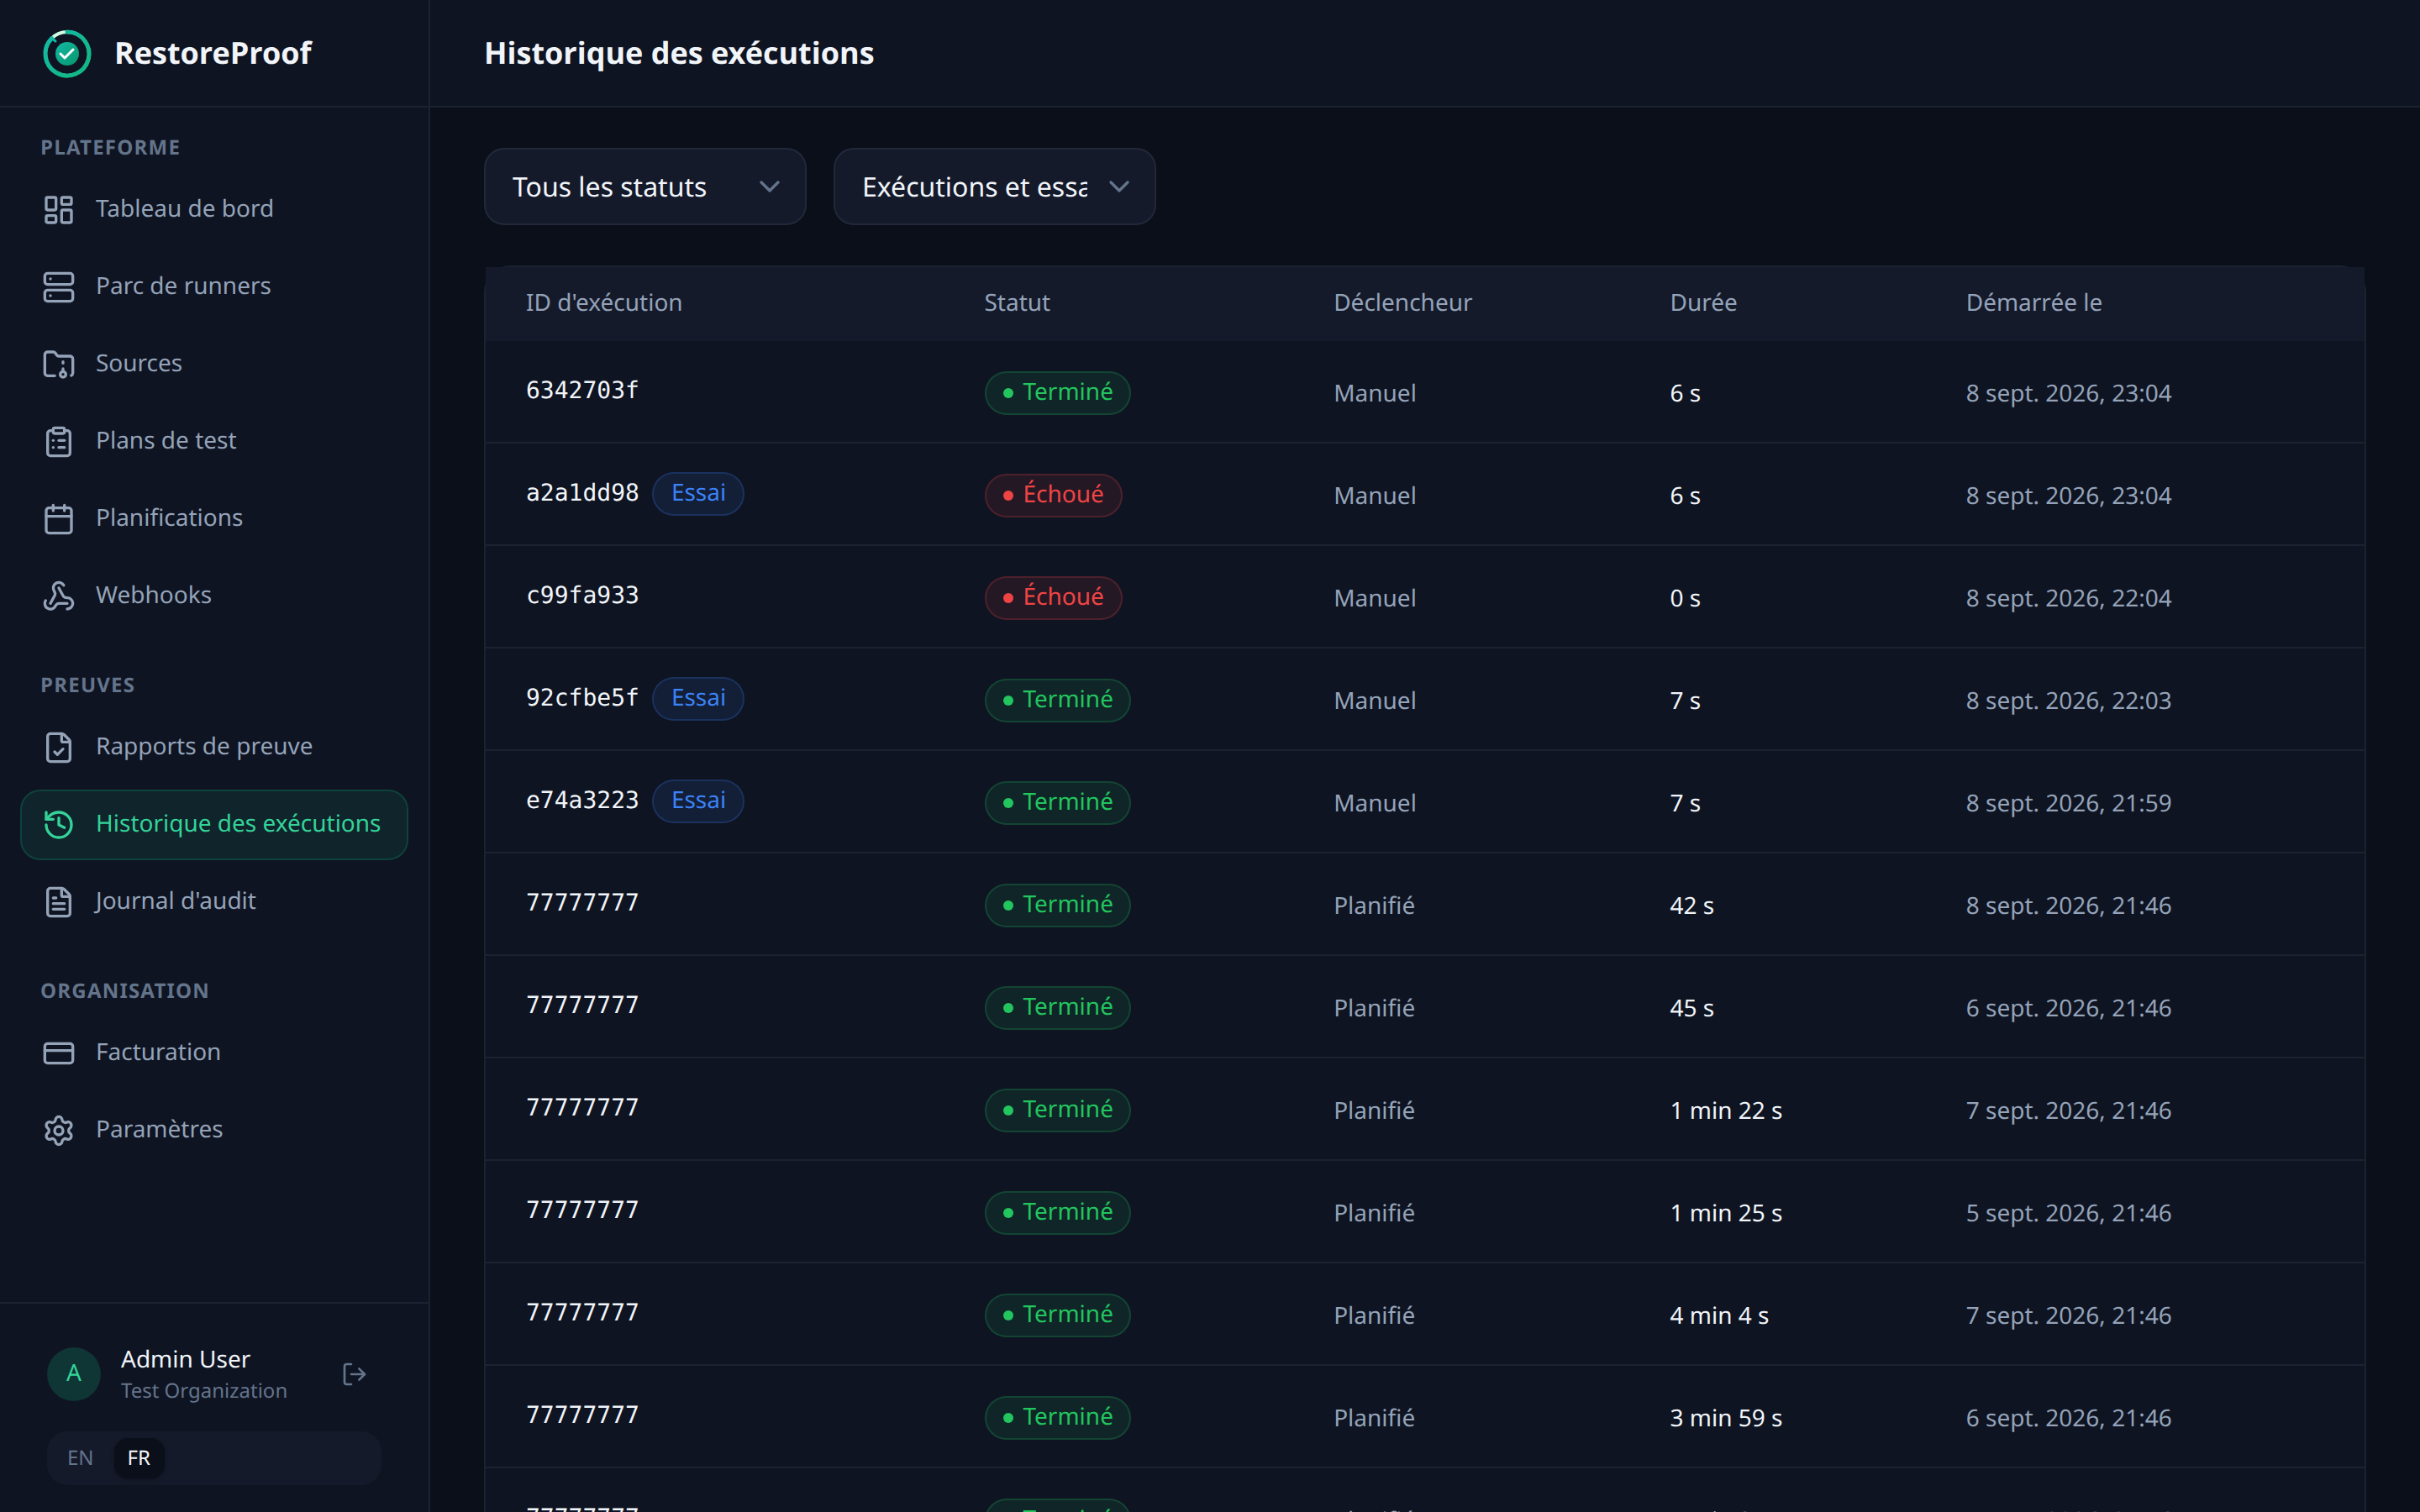
Il reste à choisir une fréquence. Chaque nuit place l'exécution à 2 h du matin : votre script de sauvegarde tourne à 1 h, les deux fichiers ont donc une heure quand ils sont éprouvés. L'autre déclenchement possible est un appel HTTP à la fin de ce script — le test porte alors exactement sur les fichiers qui viennent d'être produits. Comme il y a deux plans, l'historique montre deux lignes par nuit, et c'est là que se voit celui des deux qui casse.
Ce que cette chaîne ne prouve pas
Elle prouve qu'un dump récent se rejoue dans un MySQL neuf, que la base restaurée contient vos comptes, vos articles publiés et l'adresse du site, et que l'archive contient l'arborescence et le volume de médias attendus.
Elle ne prouve pas que les deux moitiés viennent du même instant. Le dump et l'archive sont produits l'un après l'autre : un média téléversé entre les deux est référencé dans la base sans être dans l'archive. L'écart est de quelques minutes, mais il existe, et il se réduit en rapprochant les deux commandes, pas en testant davantage.
Elle ne prouve pas non plus que chaque extension redémarre : une extension qui attend une table hors préfixe, une licence ou un service externe peut très bien échouer sur une base par ailleurs complète. Et elle ne dit rien de ce qui a été publié depuis le dernier dump — cet écart, c'est votre RPO, et il se règle avec la fréquence des sauvegardes, pas avec les tests.
Enfin, si vous avez choisi de laisser wp-config.php dehors, la restauration réelle demande de le réécrire. Ce geste-là n'est dans aucun des deux plans : gardez-le dans votre procédure écrite.
Éprouver ses sauvegardes sans y penser
RestoreProof rejoue ces étapes sur votre infrastructure, aussi souvent que vous le décidez : il récupère la sauvegarde, la restaure dans un conteneur jetable, pose les mêmes questions, détruit tout, et signe le résultat. Vos données ne sortent pas de votre réseau.
FAQ
Faut-il sauvegarder la base ou les fichiers ?
Les deux, et séparément. La base porte les articles, les comptes et les réglages ; wp-content porte les médias, les thèmes et les extensions. Avec la base seule, chaque article pointe vers des images qui n'existent plus. Avec les fichiers seuls, rien ne rattache un média à un article.
Faut-il sauvegarder tout le dossier /var/www/html ?
Non. Le cœur de WordPress — wp-admin, wp-includes, les fichiers PHP de la racine — est un téléchargement public qu'on récupère à la version voulue. Les caches se régénèrent. Ce qui n'existe qu'une fois, c'est wp-content.
Et wp-config.php ?
Il contient les identifiants de votre base de production et les clés de salage des cookies. Le sauvegarder économise une demi-heure le jour de la restauration et met un mot de passe de production dans une archive qui part sur un stockage distant. Les clés de salage, elles, se regénèrent : les perdre déconnecte tout le monde une fois, rien de plus.
Le site restauré répond en 200 : la restauration est-elle prouvée ?
Non : une installation neuve répond 200 elle aussi. Ce qui prouve quelque chose, c'est un de vos articles qui revient par l'API REST, et l'adresse d'un média de cet article qui rend autre chose qu'un 404. Une base complète, un site qui répond et des images en 404, c'est le cas que la moitié des sauvegardes WordPress ne voient jamais.
Mes tables ne sont pas préfixées wp_ : qu'est-ce que ça change ?
Les requêtes de vérification, qui nomment les tables une par une. wp_ est un défaut, pas une règle : sur un site qui a changé de préfixe, une requête écrite avec wp_ interroge des tables qui n'existent pas et échoue au lieu de compter. Le préfixe se lit dans wp-config.php, sur la ligne $table_prefix.