Sauvegarder Vaultwarden et vérifier que le coffre est restaurable
Un gestionnaire de mots de passe restauré à moitié est pire qu'un gestionnaire perdu : il a l'air complet. Les comptes sont là, les entrées sont là, et personne ne s'aperçoit de rien jusqu'au jour où quelqu'un entre son mot de passe maître et où rien ne se déchiffre.
Ce guide monte la chaîne entière pour Vaultwarden. À la fin, vous saurez ce qu'une sauvegarde doit contenir en plus de la base, pourquoi copier un fichier SQLite pendant qu'il est ouvert n'en est pas une, comment écrire un script qui ne peut pas annoncer un succès sur une archive tronquée, comment restaurer dans un conteneur jetable et ouvrir réellement le coffre, et quelles requêtes disent qu'un coffre restauré est encore un coffre.
Tout cela fonctionne avec sqlite3, tar, docker et l'AWS CLI, et rien d'autre. La dernière section montre comment faire tourner cette même vérification sur une planification plutôt qu'à la main — c'est le travail de RestoreProof — mais la procédure tient debout seule.
Le coffre n'est pas dans la base
Vaultwarden ne connaît aucun de vos mots de passe. Chaque entrée est chiffrée dans le navigateur avant d'être envoyée, et le serveur ne stocke que le bloc chiffré, dans la colonne data de la table ciphers. Le mot de passe maître, lui, ne quitte jamais le poste de l'utilisateur.
Ce que le serveur garde, c'est le matériel de chiffrement de chaque compte, dans la table users :
akey, la clé symétrique du compte, elle-même chiffrée par une clé dérivée du mot de passe maître ;private_keyetpublic_key, la paire RSA qui sert aux partages.
D'où la conséquence qui rend ce sujet différent de celui d'une base d'application ordinaire : une base restaurée sans ce matériel ne rend aucun secret lisible. Les comptes sont là, les entrées sont là, chacun entre son mot de passe maître, et rien ne se déchiffre — définitivement, parce que la clé qui manque n'existe nulle part ailleurs. Un export partiel, une colonne tronquée, une table users restaurée depuis une sauvegarde plus ancienne que ciphers : dans les trois cas, le coffre a l'air complet et il est perdu.
Ce qu'il y a à côté de la base
Le dossier de données de Vaultwarden — /data dans le conteneur — contient ce que la base ne contient pas :
| Contenu | Ce que c'est |
|---|---|
rsa_key.pem | la clé qui signe les jetons de session |
attachments/ | les pièces jointes des entrées, chiffrées elles aussi |
sends/ | les fichiers des envois Bitwarden Send |
icon_cache/ | les favicons des sites, un cache, rien à sauvegarder |
config.json | les réglages faits depuis la page d'administration |
rsa_key.pem n'est pas la clé du coffre : elle signe les jetons. Perdue, Vaultwarden en fabrique une autre au démarrage, tout le monde se reconnecte, et les coffres restent lisibles. Les pièces jointes, elles, sont référencées par la base : une base restaurée avec une arborescence attachments/ prise à une autre heure donne des entrées qui pointent vers des fichiers absents.
Une sauvegarde Vaultwarden, c'est donc deux morceaux pris ensemble : la base et le dossier de données.
Deux installations, deux façons de sauvegarder
SQLite, l'installation par défaut
Sans DATABASE_URL, Vaultwarden écrit dans db.sqlite3, à la racine du dossier de données. Copier ce fichier pendant que le service tourne n'est pas une sauvegarde : SQLite garde les transactions récentes dans un journal -wal à côté, et un cp attrape un fichier et pas l'autre, ou les deux à deux instants différents.
Un
cpdedb.sqlite3à chaud produit un fichier qui s'ouvreC'est ce qui rend le piège coûteux : le fichier copié n'est pas vide, il s'ouvre, il contient des tables. Ce sont les dernières écritures qui manquent, ou les pages qui sont incohérentes entre elles. La commande
.backupdesqlite3prend un verrou de lecture, suit le journal, et produit un fichier cohérent sans arrêter le service.
PostgreSQL ou MySQL
Avec DATABASE_URL, la base est ailleurs et se sauvegarde comme n'importe quelle base. Le détail du dump, des formats et de ce que pg_dump laisse dehors est dans Sauvegarder PostgreSQL vers S3 ; seule la ligne change :
pg_dump -h db.interne -U sauvegarde -d vaultwarden --no-owner --no-acl \
  | gzip > "/backups/vaultwarden_${ts}.sql.gz"
Dans les deux cas, le dossier de données se sauvegarde de la même façon.
Le script de sauvegarde
#!/bin/bash
set -euo pipefail

ts=$(date +%Y%m%d_%H%M%S)
src=/var/lib/vaultwarden
dest=s3://sauvegardes-vaultwarden

sqlite3 "${src}/db.sqlite3" ".backup '/backups/db_${ts}.sqlite3'"
gzip -9 "/backups/db_${ts}.sqlite3"

tar -cf - -C "${src}" --exclude=./icon_cache --exclude='./db.sqlite3*' . \
  | gzip > "/backups/data_${ts}.tar.gz"

aws s3 cp "/backups/db_${ts}.sqlite3.gz" "${dest}/"
aws s3 cp "/backups/data_${ts}.tar.gz" "${dest}/"
La base est exclue de l'archive : elle a déjà été prise proprement par .backup, et l'inclure au tar remettrait dans la sauvegarde la copie à chaud qu'on vient d'éviter. icon_cache est exclu parce que Vaultwarden le reconstruit tout seul.
Sans
pipefail, une archive tronquée ressort en succèsDans
tar -cf - … | gzip > fichier, le shell ne regarde que le code de sortie du dernier maillon. Sitars'arrête en route — un fichier disparu sous lui, un disque plein —gzipcompresse quand même ce qu'il a reçu et rend 0. Le script rend 0, le cron est content, et l'archive contient la moitié du dossier.set -o pipefail, inclus dans leset -euo pipefailci-dessus, fait échouer la ligne entière dès quetaréchoue.
Gardez l'horodatage dans les deux noms de fichiers, et gardez-les appariés : c'est la paire base + dossier prise à la même minute qui se restaure, pas le dernier fichier de chaque côté. Pour la rétention, une règle de cycle de vie sur le bucket supprime les objets de plus de N jours sans script à maintenir.
Restaurer une fois, à la main
Une sauvegarde n'est prouvée que restaurée. Faites-le une fois, entièrement, dans un conteneur jetable — c'est aussi la procédure que vous suivrez le jour où ça compte.
mkdir -p /tmp/vw-essai/data
tar -xzf /backups/data_20260918_010000.tar.gz -C /tmp/vw-essai/data
gunzip -c /backups/db_20260918_010000.sqlite3.gz > /tmp/vw-essai/data/db.sqlite3

docker run -d --name vw-essai -p 8080:80 \
  -e DOMAIN=http://localhost:8080 \
  -v /tmp/vw-essai/data:/data \
  vaultwarden/server:<votre version>
L'image doit porter la version de production
Vaultwarden applique ses migrations de schéma au démarrage. Une image plus ancienne que celle qui a écrit la base refuse de démarrer dessus, et une image plus récente migre le fichier restauré — ce qui est le bon comportement pour une vraie restauration, mais pas ce que vous voulez d'un essai. Reprenez la version exacte de votre production, pas
latest.
Ouvrez ensuite http://localhost:8080 dans un navigateur, connectez-vous avec le mot de passe maître d'un compte, et affichez le mot de passe d'une entrée. C'est la seule manipulation qui prouve que le coffre se déchiffre. Elle demande un humain qui connaît un mot de passe maître : personne d'autre ne peut la faire, et c'est exactement ce que vous attendez d'un gestionnaire de mots de passe.
Notez le temps que ça a pris. C'est votre durée de restauration réelle.
Ce qu'on vérifie dans une base restaurée
Le fichier s'ouvre ne veut pas dire que le coffre est là. Quatre questions, dans cet ordre :
select count(*) from users where length(password_hash) > 0;
select count(*) from ciphers;
select max(updated_at) from ciphers;
select count(*) from users
 where length(password_hash) > 0
   and (akey is null or akey = '' or private_key is null or public_key is null);
- Il reste des comptes. Un compte sans empreinte de mot de passe est un compte invité qui ne s'est jamais connecté, pas un utilisateur.
- Il reste des entrées. Comparez à l'ordre de grandeur de la production, pas à un chiffre exact : un coffre qui grossit, c'est normal.
- Les entrées sont récentes. La dernière modification doit être d'hier, pas du mois dernier. C'est ce qui attrape un job de sauvegarde qui a cessé de tourner.
- Le matériel de chiffrement a suivi. Cette requête doit rendre zéro. Un compte activé qui a perdu son
akeyou sa paire de clés, c'est un coffre illisible qui a l'air intact — le cas décrit en haut de cette page.
Côté fichiers, deux commandes suffisent :
ls -l /tmp/vw-essai/data/rsa_key.pem
find /tmp/vw-essai/data -type f | wc -l
La clé de signature est là, et l'arborescence n'a pas fondu. Retenez ce second nombre : c'est le plancher que vous donnerez à la vérification automatique.
Puis détruisez tout : docker rm -f vw-essai et rm -rf /tmp/vw-essai. Les données que vous venez de manipuler sont un coffre de production.
Automatiser cette vérification
Ce qui précède coûte une heure ou deux, à chaque fois. C'est pour cette raison que ces tests, faits à la main, finissent par ne plus être faits.
RestoreProof rejoue ces étapes en tâche planifiée, sur votre infrastructure : un runner récupère la sauvegarde, la restaure dans un conteneur jetable, pose les mêmes questions, détruit tout, et signe le résultat. Les données ne sortent pas de chez vous.
Déclarez d'abord chaque sauvegarde comme source — le dossier ou le bucket, le motif de nom de fichier, et la stratégie le plus récemment modifié. Les identifiants ne se saisissent pas : le plan porte une référence que le runner résout dans son propre environnement. Voir le mot de passe du bac à sable et comment adapter le bloc fetch.
Comme pour la sauvegarde, la base et le dossier de données font deux plans distincts : celui qui échoue vous dit alors lequel des deux morceaux est en cause. Chaque commande que vous venez de taper a son étape :
| À la main | Dans le plan |
|---|---|
aws s3 cp depuis le bucket | fetch, qui prend le fichier le plus récent |
gunzip -c, tar -xzf | unpack |
docker run postgres:16-alpine | start_sandbox, pour une installation PostgreSQL |
psql -v ON_ERROR_STOP=1 | restore_postgres, pour une installation PostgreSQL |
sqlite3 db.sqlite3 sur une copie | une sonde sqlite, sans bac à sable |
| les quatre requêtes | une sonde par question |
ls -l rsa_key.pem, find … | wc -l | une sonde filesystem-canary |
docker rm -f | le nettoyage, toujours exécuté |
Les sondes employées, et ce que chacune prouve :
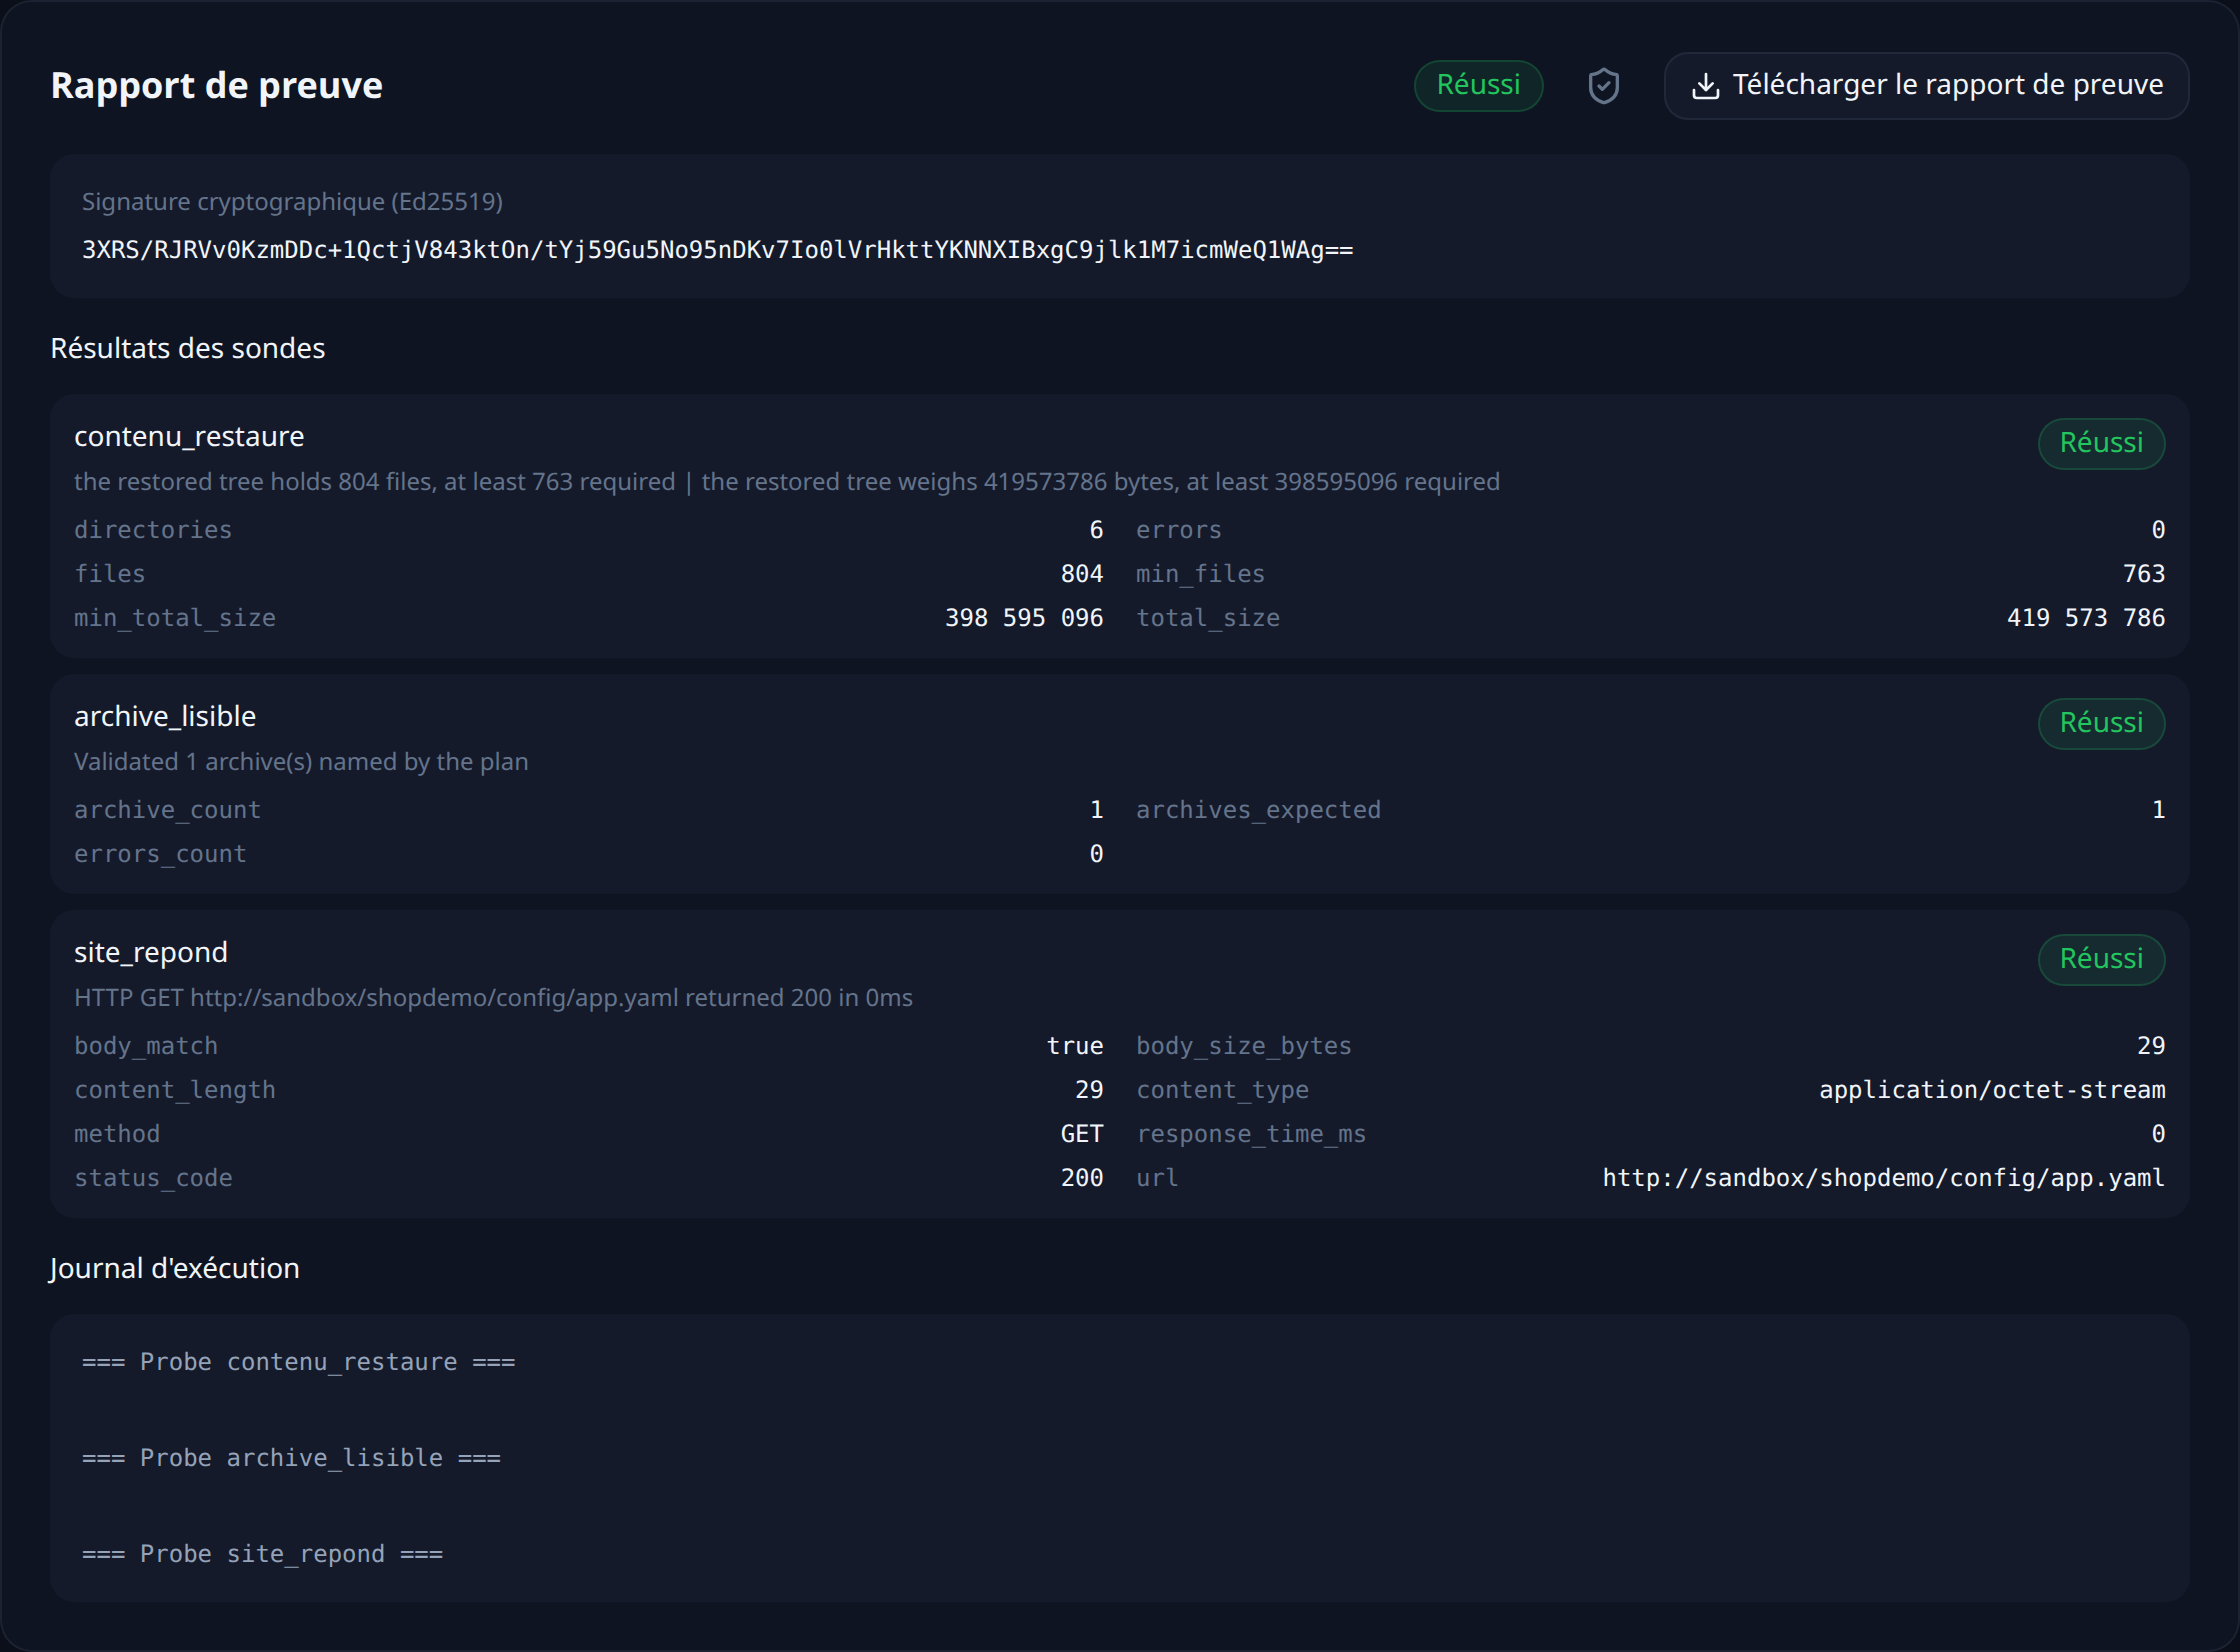
sqliteenRESTOREPROOF_SQLITE_INTEGRITY: fulllit chaque page du fichier. C'est ce qu'unsha256sumne dit pas : une empreinte prouve que le fichier n'a pas changé depuis la copie, pas qu'il était valide au moment de la copie. Une sauvegarde faite aucpsur une base vivante rate ce contrôle. La sonde travaille sur une copie du fichier, parce que SQLite a besoin d'écrire pour rejouer le journal-walà l'ouverture.sqliteoupostgrespour les comptes et les entrées, avec l'opérateurgteet un plancher.sqliteoupostgrespour le matériel de chiffrement, avec l'opérateurzero: la sonde n'attend pas un nombre, elle exige qu'il n'y ait aucun compte concerné. C'est la sonde qui vaut le détour.filesystem-canarypourdata/rsa_key.pem, avecRESTOREPROOF_CANARY_MIN_FILESetRESTOREPROOF_CANARY_MIN_TOTAL_SIZE: le fichier attendu est là, et l'arborescence pèse encore ce qu'elle doit peser.
Une précision sur la sonde sqlite : RESTOREPROOF_SQLITE_TARGET attend un nom de table et le cite tel quel, une condition ne passe donc pas par là. Les requêtes avec un where s'écrivent dans RESTOREPROOF_SQLITE_QUERY, qui doit rendre un seul nombre.
Le seul ajout par rapport à ce que vous avez fait à la main est max_age, et c'est le contrôle qu'une restauration ne peut pas déduire du contenu : il fait échouer l'exécution quand la sauvegarde la plus récente trouvée à la source est plus vieille que ce délai. Les plans complets, prêts à coller dans l'éditeur, sont dans la recette des applications auto-hébergées.
Ce que cette vérification ne fait pas : elle ne déchiffre rien. Aucune sonde ne connaît de mot de passe maître, et c'est voulu — il n'existe pas d'endroit où le déposer qui ne soit pas un endroit où le voler. Elle prouve que le matériel de chiffrement est présent, complet et rattaché aux bons comptes. L'ouverture réelle d'un coffre reste la manipulation de la section précédente, à refaire de temps en temps, à la main.
Les seuils ne se recopient pas depuis cette page. Un essai restaure votre sauvegarde, compte ce qu'elle contient réellement, et propose chaque seuil 5 % sous la valeur mesurée, avec l'opérateur gte.
Il reste à choisir une fréquence. Chaque nuit place l'exécution après votre script de sauvegarde : la sauvegarde a alors une heure quand elle est éprouvée. L'autre déclenchement possible est un appel HTTP à la fin de ce script — le test porte alors exactement sur les fichiers qui viennent d'être produits.
Chaque exécution laisse un rapport horodaté, signé, qui nomme la sauvegarde éprouvée et ce que chaque sonde a mesuré.
Ce que cette chaîne ne prouve pas
Elle prouve qu'une sauvegarde récente s'ouvre, qu'elle contient des comptes et des entrées, et que le matériel de chiffrement de chaque compte est intact. Elle ne prouve pas qu'une entrée se déchiffre : cela demande un mot de passe maître, qui n'a pas à être ici. Les deux plans étant indépendants, rien ne vérifie non plus que chaque pièce jointe citée par la base existe dans l'archive du dossier de données — c'est la raison pour laquelle les deux sauvegardes se prennent à la même minute. Et elle ne dit rien de ce qui a été ajouté au coffre depuis la dernière sauvegarde : cet écart, c'est votre RPO, et il se règle avec la fréquence des sauvegardes, pas avec les tests.
Éprouver ses sauvegardes sans y penser
RestoreProof rejoue ces étapes sur votre infrastructure, aussi souvent que vous le décidez : il récupère la sauvegarde, la restaure dans un conteneur jetable, pose les mêmes questions, détruit tout, et signe le résultat. Vos données ne sortent pas de votre réseau, et rien n'est déchiffré.
FAQ
Suffit-il de sauvegarder la base de Vaultwarden ?
Non. Le dossier de données contient la clé qui signe les jetons de session, les pièces jointes des entrées et les fichiers des envois. Et surtout, les deux morceaux se tiennent : les pièces jointes sont référencées par la base, donc une base et une arborescence prises à deux heures différentes donnent des entrées qui pointent vers des fichiers absents.
Peut-on copier db.sqlite3 pendant que Vaultwarden tourne ?
Pas avec cp. SQLite garde les écritures récentes dans un journal -wal à côté du fichier principal, et une copie simple attrape l'un sans l'autre. La commande .backup de sqlite3 produit un fichier cohérent sans arrêter le service.
Une sauvegarde de Vaultwarden contient-elle mes mots de passe en clair ?
Non : chaque entrée est chiffrée dans le navigateur avant d'arriver au serveur, et le mot de passe maître ne quitte jamais le poste de l'utilisateur. Une sauvegarde reste néanmoins à traiter comme le coffre lui-même, parce qu'elle contient tout ce qu'il faut pour attaquer hors ligne les mots de passe maîtres.
Comment vérifier qu'un coffre restauré se déchiffre vraiment ?
En se connectant, avec un mot de passe maître, et en affichant une entrée. Une vérification automatique ne peut pas le faire, et ne doit pas pouvoir le faire : il n'existe pas d'endroit où déposer un mot de passe maître qui ne soit pas un endroit où le voler. Ce qu'elle vérifie, c'est que le matériel de chiffrement de chaque compte est présent et complet — ce qui est la panne qu'on ne voit pas.
Quelle version de l'image faut-il pour le test de restauration ?
Celle de votre production, exactement, pas latest. Vaultwarden applique ses migrations de schéma au démarrage : une image plus ancienne que celle qui a écrit la base refuse de démarrer dessus, et une image plus récente migre le fichier restauré. C'est le bon comportement pour une vraie restauration, pas pour un test, qui doit lire la base telle qu'elle a été sauvegardée.