Sauvegarder MongoDB vers S3 : de mongodump à la restauration vérifiée
La plupart des guides de sauvegarde MongoDB s'arrêtent à la ligne mongodump. C'est la partie facile. Ce qui décide si vous récupérez vos données, c'est ce qui l'entoure : ce que le dump laisse dehors, les options qui changent ce que vous pourrez restaurer, le fait que le script échoue vraiment quand le dump échoue, et le fait que quelqu'un ait déjà rejoué le fichier au moins une fois.
Ce guide monte la chaîne entière. À la fin, vous saurez ce qu'un mongodump contient et ce qu'il laisse au serveur, quand --oplog sert à quelque chose, comment écrire un script de sauvegarde qui ne peut pas annoncer un succès sur un fichier vide, comment restaurer l'archive à la main dans un conteneur jetable, et quelles questions posées dans mongosh disent qu'une base restaurée contient réellement vos données.
Tout cela fonctionne avec mongodump, docker et l'AWS CLI, et rien d'autre. La dernière section montre comment faire tourner cette même restauration et ces mêmes vérifications sur une planification plutôt qu'à la main — c'est le travail de RestoreProof — mais la procédure tient debout seule, et le jour où ça compte, c'est elle que vous suivrez.
Ce qu'un mongodump sauvegarde, et ce qu'il laisse dehors
mongodump lit les documents par le protocole du serveur, comme n'importe quel client. Il sauvegarde donc des données, pas un serveur :
- les utilisateurs et les rôles n'en font pas partie. Ils vivent dans la base
admin, danssystem.usersetsystem.roles; un dump limité à votre base métier ne les contient pas, et la restauration donne alors une base intacte où aucun compte applicatif n'existe ; - la configuration du serveur non plus : les paramètres de l'instance, la composition du jeu de réplicas, le découpage d'un cluster partitionné ;
- les autres bases du même serveur, sauf si vous demandez un dump complet.
Les index, eux, sont dans le dump — leur définition, pas leur contenu. mongorestore écrit d'abord les documents, puis reconstruit chaque index. Sur une grosse collection, c'est là que passe l'essentiel du temps de restauration, et c'est la raison pour laquelle une restauration est presque toujours plus lente que le dump qui l'a produite.
Un dump n'est pas une copie du répertoire de données
Les deux se défendent, mais ils ne donnent pas la même chose.
Un dump est logique : les documents sont relus, réinsérés, les index refaits. Il se restaure dans une autre version de MongoDB, sur une autre machine, dans une topologie différente — un dump pris sur un jeu de réplicas se recharge sur un serveur seul.
Une copie du répertoire de données (--dbpath) est physique : ce sont les fichiers du moteur de stockage. Elle se restaure beaucoup plus vite sur de gros volumes, mais elle ne vaut que pour la même version de MongoDB et le même moteur de stockage, et elle ne peut pas être prise en copiant les fichiers d'un serveur en marche — il faut l'arrêter, ou passer par un instantané du système de fichiers qui capture le journal en même temps que les données.
Pour une base de quelques gigaoctets, mongodump reste le choix simple : un fichier, lisible par n'importe quel MongoDB récent.
Les options qui décident de ce que vous pourrez restaurer
--archive écrit tout dans un flux unique au lieu d'une arborescence de fichiers BSON. C'est un objet à envoyer au lieu d'un répertoire à synchroniser, et mongorestore le relit tel quel.
--gzip compresse. Avec --archive, la compression se fait dans le flux : pas de fichier intermédiaire, et mongorestore --gzip le relit sans décompression préalable.
--oplog change la nature de la sauvegarde. Sans lui, un dump qui dure plusieurs minutes mélange des documents lus à des instants différents : une commande peut y figurer sans la ligne de facturation écrite dans la même transaction. Avec lui, mongodump note la position de l'oplog avant de commencer, puis joint les opérations survenues pendant la lecture, et mongorestore --oplogReplay les rejoue à la fin : le résultat est l'état de la base à un instant précis. Deux conditions : l'oplog n'existe que sur un jeu de réplicas, et l'option ne s'applique qu'à un dump complet de l'instance, pas à un --db.
Enfin, le nom de la base est dans le dump. mongodump enregistre chaque collection sous son namespace complet, boutique.commandes, et mongorestore la réécrit sous ce même nom. Renommer le fichier ne change rien. C'est ce qui rend l'erreur de la section restauration si facile à commettre.
Le script de sauvegarde
#!/bin/bash
set -euo pipefail

ts=$(date +%Y%m%d_%H%M%S)
dest=s3://sauvegardes-boutique/mongo

mongodump --host mongo.interne --port 27017 --db boutique --archive \
  | gzip > "/backups/boutique_${ts}.archive.gz"

aws s3 cp "/backups/boutique_${ts}.archive.gz" "${dest}/"
Sans
pipefail, un dump raté ressort en succèsDans
mongodump | gzip, le shell ne regarde que le code de sortie du dernier maillon.gzipcompresse très bien une sortie vide, donc le script rend 0 et le cron est content.set -o pipefail— inclus dans leset -euo pipefailci-dessus — fait échouer la ligne entière dès quemongodumpéchoue. La variante sans tuyau,--archive=/backups/... --gzip, supprime le problème à la source :mongodumpécrit le fichier lui-même et son code de sortie est celui de la commande.
Gardez l'horodatage dans le nom du fichier : un fichier toujours écrasé au même nom ne laisse aucune chance de revenir à la veille. Pour la rétention, une règle de cycle de vie sur le bucket supprime les objets de plus de N jours sans script à maintenir.
Le compte qui prend le dump a besoin de lire toute la base. Un rôle trop étroit ne provoque pas d'erreur visible : il produit un dump où les collections qu'il ne voit pas sont simplement absentes.
Reste à le lancer chaque nuit. Un cron suffit, à deux conditions : que sa sortie d'erreur aille quelque part où quelqu'un la lit, et qu'une exécution qui s'éternise n'en croise pas une autre — flock -n sur un fichier verrou règle le second point en une ligne.
Restaurer une fois, à la main
Une sauvegarde n'est prouvée que restaurée. Faites-le une fois, entièrement, sur un conteneur jetable — c'est aussi la procédure que vous suivrez le jour où ça compte.
docker run -d --name mongo-essai mongo:7
until docker exec mongo-essai mongosh --quiet --eval 'db.runCommand({ping:1})'; do sleep 1; done

docker cp /backups/boutique_20260918_010000.archive.gz mongo-essai:/tmp/dump.gz
docker exec mongo-essai mongorestore --archive=/tmp/dump.gz --gzip --drop \
  --nsInclude 'boutique.*' --stopOnError
--drop supprime chaque collection avant de la réécrire : sans lui, une restauration dans un conteneur déjà utilisé mélange les documents de deux essais. --stopOnError arrête à la première insertion refusée, au lieu de continuer et de vous rendre une base à moitié restaurée qui a l'air de marcher.
Le nom de la base est celui du dump, pas celui que vous voulez
Si l'archive a été prise sur une base nommée
shop, le--nsInclude 'boutique.*'ci-dessus ne correspond à rien :mongorestorene restaure aucun document, et il sort en succès. Rien dans la base ne vous alerte, il n'y a pas de base. Pour restaurer sous un autre nom, il faut le dire :--nsFrom 'shop.*' --nsTo 'boutique.*'.
Prenez le temps que ça a pris. C'est votre durée de restauration réelle, la seule à comparer au délai que vous avez promis.
Ce qu'on vérifie dans une base restaurée
mongorestore s'est terminé sans erreur ne veut pas dire que les données sont là. Quatre questions, dans cet ordre, depuis un mongosh ouvert sur le conteneur :
use boutique
show collections
db.commandes.countDocuments()
db.commandes.find().sort({ cree_le: -1 }).limit(1)
db.commandes.getIndexes().length
- Les collections sont là. Une liste vide, c'est un
--nsIncludequi n'a rien reconnu, ou un dump vide qui s'est rejoué parfaitement. - Les documents sont là.
countDocuments()compte vraiment, contrairement àestimatedDocumentCount()qui lit les métadonnées de la collection et peut annoncer des documents qui ne sont plus là. Comparez à l'ordre de grandeur de la production, pas à un chiffre exact. - Les données sont récentes. Le document le plus récent doit dater d'hier, pas du mois dernier. C'est ce qui attrape un job de sauvegarde qui a cessé de tourner sans rien dire.
- Les index ont été reconstruits. Une collection revenue avec ses documents mais sans ses index se comporte correctement et répond en secondes au lieu de millisecondes. Sur une base de production remise en service, ça suffit à la rendre inutilisable.
Puis détruisez tout : docker rm -f mongo-essai.
Automatiser cette vérification
Ce qui précède coûte une heure ou deux, à chaque fois. C'est pour cette raison que ces tests, faits à la main, finissent par ne plus être faits.
RestoreProof rejoue exactement ces étapes en tâche planifiée, sur votre infrastructure : un runner récupère l'archive, la restaure dans un conteneur jetable, pose les mêmes questions, détruit tout, et signe le résultat. Les données ne sortent pas de chez vous.
Déclarez d'abord la sauvegarde comme source — le bucket, le préfixe, le motif *.archive.gz, et la stratégie le plus récemment modifié. Les clés d'accès ne se saisissent pas : le plan porte une référence, env://AWS_ACCESS_KEY_ID, que le runner résout dans son propre environnement. Voir les références de secrets.
L'assistant MongoDB écrit ensuite le plan, et ce plan est la manipulation que vous venez de faire à la main, ligne pour ligne :
| À la main | Dans le plan |
|---|---|
aws s3 cp depuis le bucket | fetch, qui prend le fichier le plus récent |
| rien à décompresser | aucune étape unpack : l'archive est lue telle quelle |
docker run mongo:7 | start_sandbox |
mongorestore --archive --gzip --drop | restore_mongo |
db.commandes.countDocuments() | une sonde mongodb par collection |
docker rm -f | le nettoyage, toujours exécuté |
La sonde mongodb se connecte à la base restaurée, compte les documents d'une collection et compare au seuil, avec gte, lte, eq ou zero. Un filtre Mongo en JSON restreint le comptage : ce n'est plus « il y a des commandes », c'est « il y a les commandes payées ». L'hôte, le port et le nom de la base ne se saisissent pas — le runner les reprend du bac à sable qu'il vient de démarrer et de l'étape restore_mongo.
Le seul ajout est max_age, et c'est celui qu'une restauration ne peut pas déduire du contenu : il fait échouer l'exécution quand la sauvegarde la plus récente trouvée à la source est plus vieille que ce délai. Une sauvegarde de mars se restaure parfaitement en septembre.
La version du bac à sable
mongo:7doit reprendre la version majeure de votre serveur. Un dump pris sur un serveur plus récent ne se rejoue pas forcément sur un plus ancien.
Les seuils ne se recopient pas depuis cette page. Un essai restaure votre sauvegarde, compte ce qu'elle contient réellement, et propose chaque seuil 5 % sous la valeur mesurée, avec l'opérateur gte.
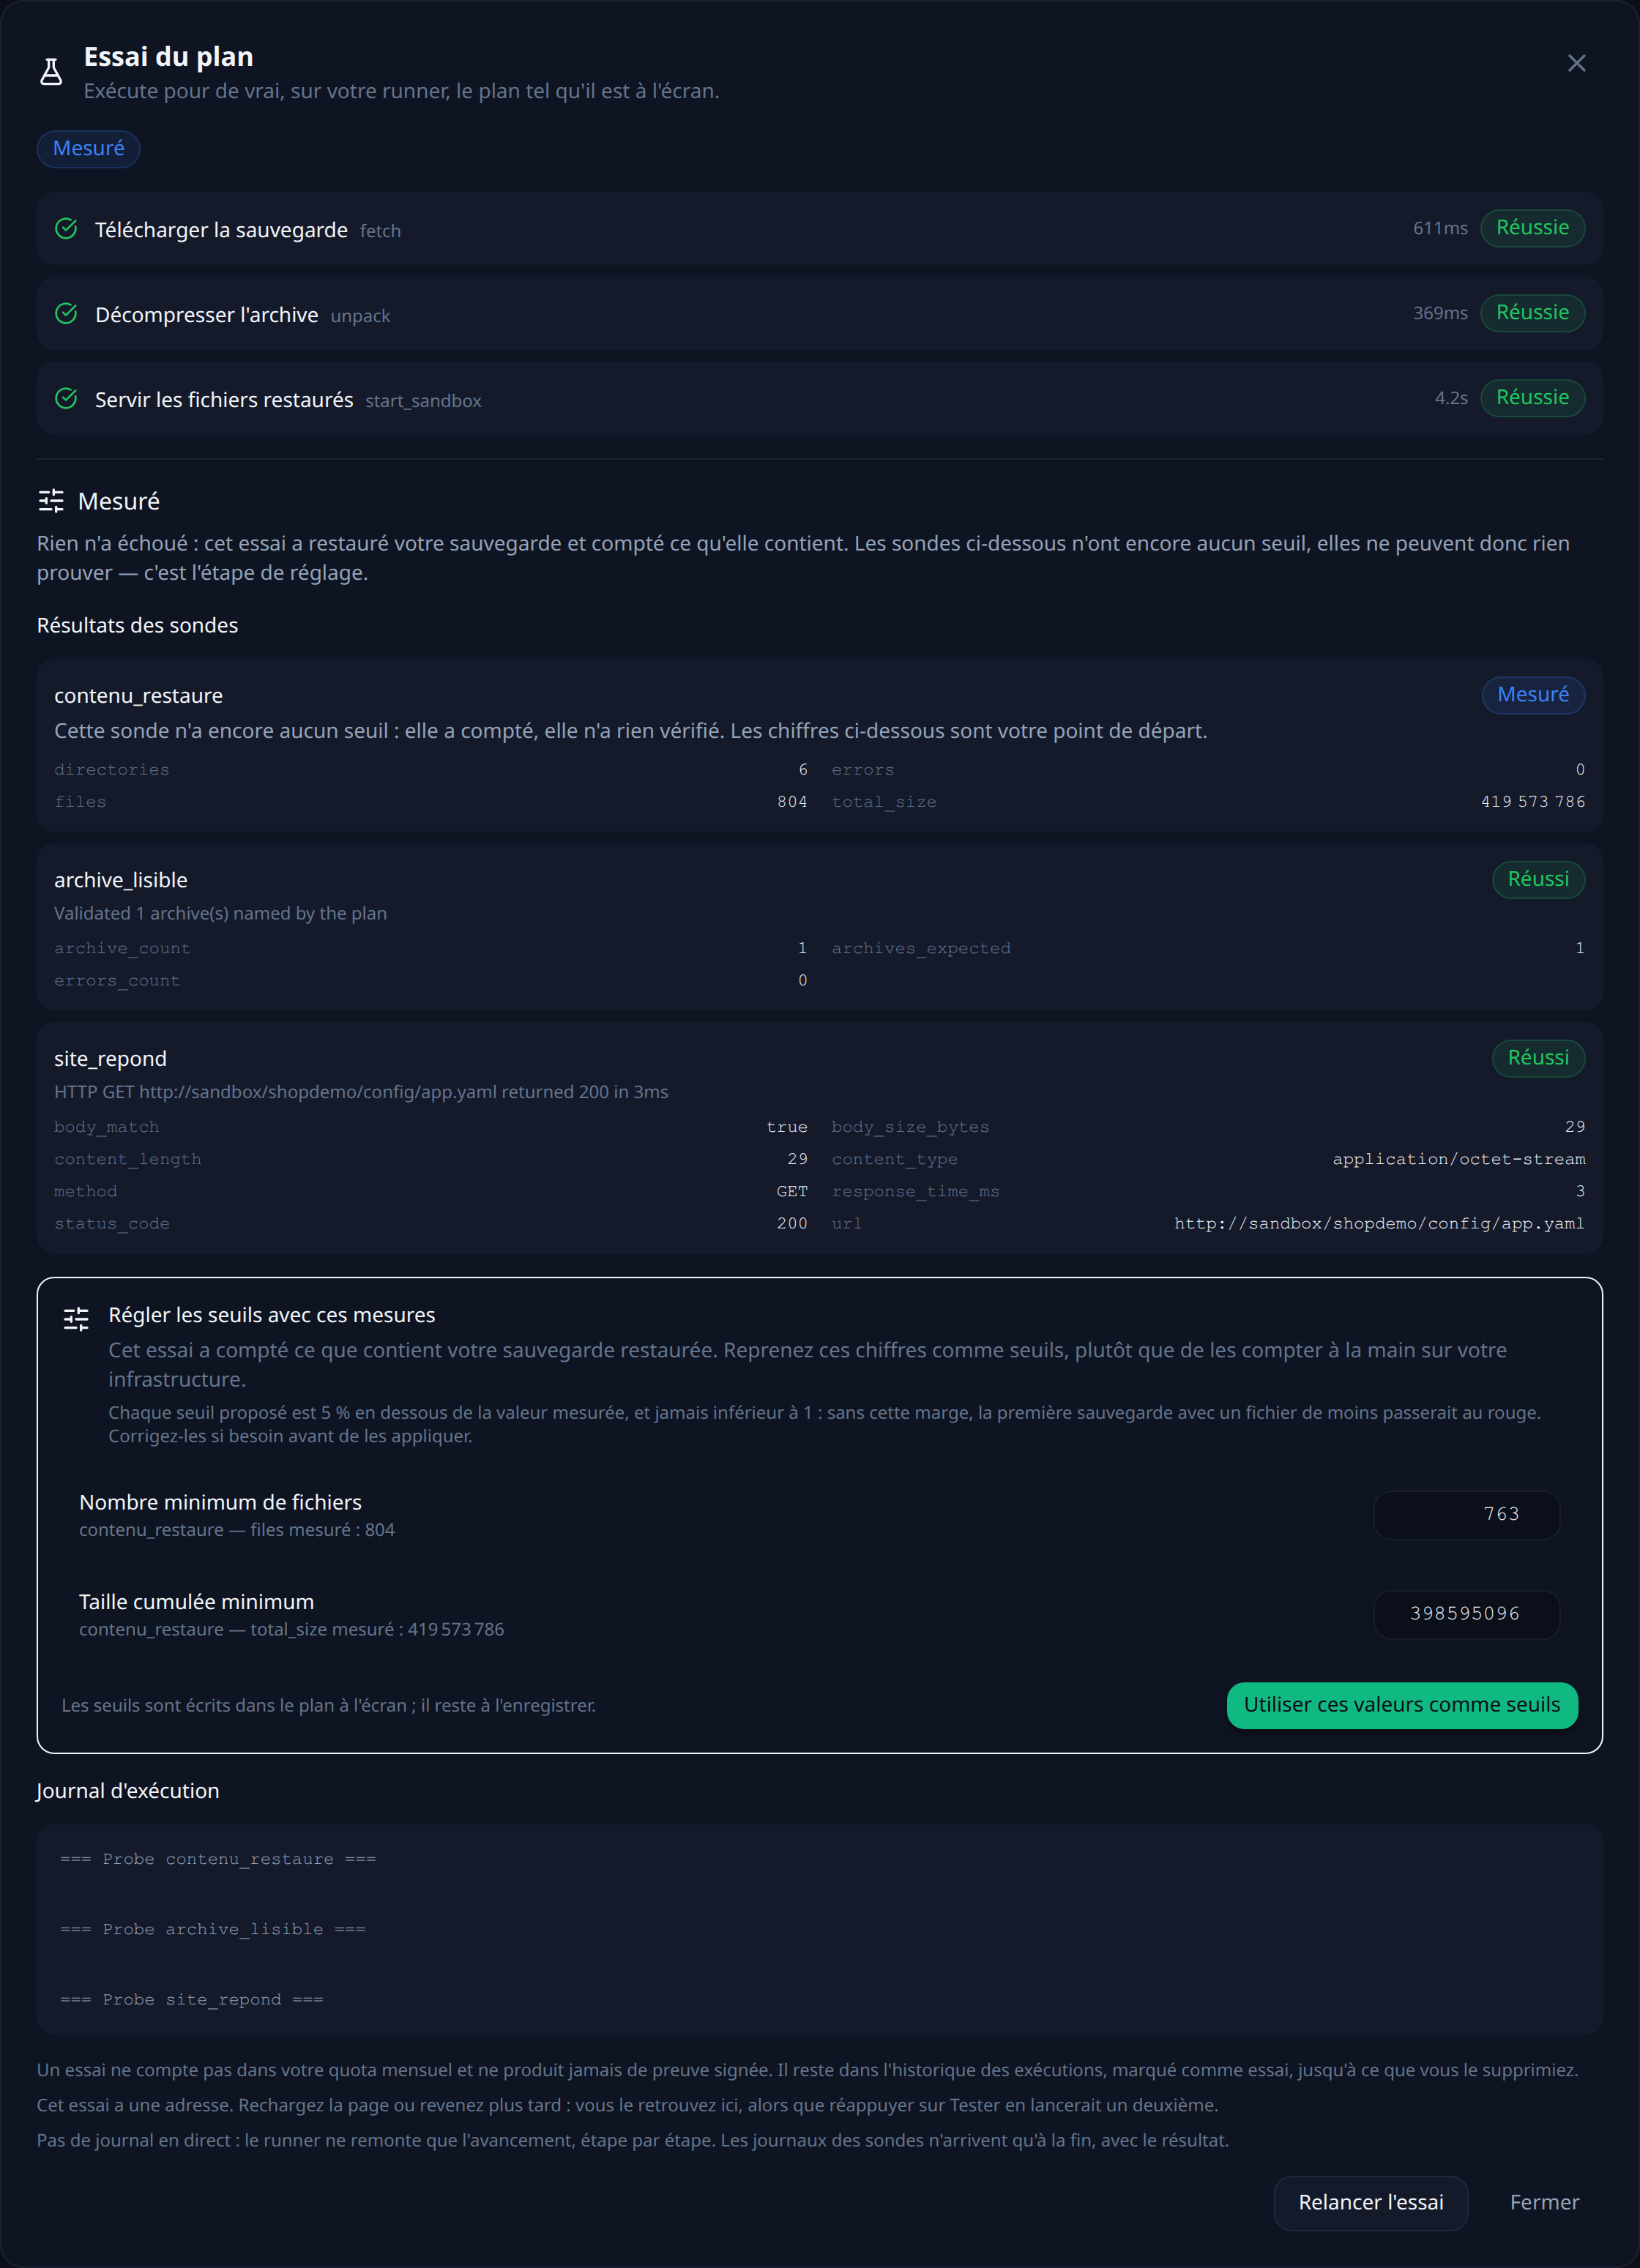
Sur MongoDB, cet essai vous apprend deux choses de plus, et elles portent toutes les deux sur les noms — le point sur lequel une restauration Mongo se casse le plus souvent.
Quand la collection nommée dans une sonde n'existe pas dans le bac à sable, la sonde liste les collections qu'elle a trouvées avec leur nombre de documents, et si la base entière est vide, elle liste les bases présentes sur le serveur. Il n'y a donc pas à deviner : le nom exact est dans le résultat, prêt à être repris.
Quant à l'étape de restauration, elle inventorie l'archive avant d'écrire quoi que ce soit. Si la base demandée par le plan n'y est pas, elle échoue tout de suite en nommant les collections que l'archive contient réellement, au lieu de restaurer zéro document et de rendre un succès comme mongorestore le ferait.
Il reste à choisir une fréquence. Chaque nuit place l'exécution à 2 h du matin : votre script de sauvegarde tourne à 1 h, l'archive a donc une heure quand elle est éprouvée. L'autre déclenchement possible est un appel HTTP à la fin de ce script — le test porte alors exactement sur le fichier qui vient d'être produit.
Chaque exécution laisse un rapport horodaté, signé, qui nomme la sauvegarde éprouvée et ce que chaque sonde a mesuré. Le plan complet et les variantes sont dans la recette MongoDB.
Ce que cette chaîne ne prouve pas
Elle prouve qu'une archive récente se restaure dans un MongoDB neuf et que les collections en reviennent avec leurs documents. Elle ne prouve pas que votre application fonctionne sur cette base : pour cela, il faut la démarrer contre le bac à sable et ajouter une sonde http. Elle ne dit rien des utilisateurs et des rôles restés dans admin, qui ne sont pas dans un dump de base métier. Et elle ne dit rien de ce qui a été écrit depuis le dernier dump — cet écart, c'est votre RPO, et il se règle avec la fréquence des sauvegardes, pas avec les tests.
Éprouver ses sauvegardes sans y penser
RestoreProof rejoue ces étapes sur votre infrastructure, aussi souvent que vous le décidez : il récupère l'archive, la restaure dans un conteneur jetable, pose les mêmes questions, détruit tout, et signe le résultat. Vos données ne sortent pas de votre réseau.
FAQ
Que faut-il sauvegarder en plus de la base métier ?
Les utilisateurs et les rôles, qui vivent dans la base admin et ne sont pas dans un dump limité à votre base. Sans eux, la restauration donne une base intacte où aucun compte applicatif n'existe et où personne ne se connecte. La configuration du serveur et la composition du jeu de réplicas ne sont pas dans le dump non plus, et c'est normal : elles appartiennent au serveur.
--oplog est-il utile sur un serveur seul ?
Non. L'oplog n'existe que sur un jeu de réplicas. Sur une instance seule, l'option n'a rien à noter, et un dump qui dure plusieurs minutes reste un mélange de documents lus à des instants différents.
Faut-il compresser une archive mongodump ?
Oui, avec --gzip, qui compresse dans le flux. L'archive compressée se restaure telle quelle : mongorestore --archive=... --gzip la relit sans décompression préalable, donc il n'y a pas de fichier intermédiaire à prévoir ni d'espace disque à réserver pour lui.
Pourquoi une restauration MongoDB échoue-t-elle sans rien restaurer ?
Presque toujours à cause d'un nom. Le nom de la base est enregistré dans le dump, pas dans le nom du fichier : un --nsInclude qui ne correspond à aucun namespace de l'archive ne restaure aucun document et sort en succès. Il faut lire ce que l'archive contient avant de la restaurer, ou renommer avec --nsFrom et --nsTo.
Pourquoi une restauration est-elle plus lente que le dump qui l'a produite ?
À cause des index. Le dump contient leur définition, pas leur contenu : mongorestore écrit d'abord les documents, puis reconstruit chaque index, et sur une grosse collection c'est là que passe l'essentiel du temps. C'est aussi pour ça qu'il faut vérifier qu'ils sont revenus : une collection rendue sans ses index répond juste, en secondes au lieu de millisecondes.