Sauvegarder Gitea : la base, les dépôts, et la preuve que le code est revenu
Une instance Gitea a l'air d'un seul service, mais elle se sauvegarde en trois morceaux qui vivent à trois endroits différents. C'est ce qui rend ses sauvegardes trompeuses : il en manque un, et tout a l'air en ordre jusqu'au jour de la restauration.
Ce guide monte la chaîne entière. À la fin, vous saurez ce que contient chacun des trois morceaux et ce qu'on perd en en oubliant un, ce que gitea dump produit vraiment et pourquoi il finit par ne plus convenir, comment écrire un script de sauvegarde qui ne peut pas annoncer un succès sur un dump vide, comment restaurer le tout à la main jusqu'au git clone qui réussit, et quelles requêtes SQL disent qu'une base restaurée décrit réellement vos dépôts.
Tout cela fonctionne avec pg_dump, tar, git et docker, et rien d'autre. La dernière section montre comment faire tourner cette même restauration et ces mêmes vérifications sur une planification plutôt qu'à la main — c'est le travail de RestoreProof — mais la procédure tient debout seule, et le jour où ça compte, c'est elle que vous suivrez.
Une sauvegarde Gitea, c'est trois choses
Gitea range ses données à trois endroits, et les trois se sauvegardent séparément. Ce découpage est la première chose à comprendre, parce qu'une sauvegarde qui n'en contient que deux a l'air complète.
La base de données — PostgreSQL, MySQL ou SQLite selon l'installation. Elle contient les comptes, les organisations, les droits d'accès, les tickets, les demandes de fusion et leurs commentaires, les étiquettes, les jalons, les clés SSH, les jetons d'accès et les webhooks. Elle contient aussi la liste des dépôts : leur nom, leur propriétaire, leur visibilité. Sans elle, les dépôts restent sur le disque et restent clonables à la main, mais Gitea ne sait plus qu'ils existent, et personne ne peut se connecter.
Le répertoire des dépôts — dans l'image Docker, /data/git/repositories. Ce sont les dépôts Git nus, un répertoire <propriétaire>/<nom>.git par dépôt : le code, tout l'historique, les branches et les étiquettes. Sans lui, la base décrit des dépôts vides. Les tickets sont encore là, le code n'y est plus.
La configuration et les fichiers joints — dans l'image Docker, tout ce qui vit sous /data/gitea. On y trouve conf/app.ini, les avatars, les pièces jointes des tickets, les paquets et les objets LFS. app.ini porte le SECRET_KEY de l'instance, avec lequel Gitea a chiffré certaines valeurs enregistrées en base — les secrets de double authentification, les mots de passe des miroirs, les secrets des applications OAuth. Restaurer la base sans ce fichier rend ces valeurs illisibles. Et un dépôt qui utilise LFS ne se clone plus complètement si les objets LFS ne sont pas revenus avec.
Les index de recherche sous /data/gitea/indexers et les journaux sous /data/gitea/log sont les deux exceptions : les premiers se reconstruisent, les seconds ne servent pas à la restauration.
gitea dump, et jusqu'où il va
Gitea sait se sauvegarder lui-même. La commande fabrique une archive unique, horodatée, qui contient les trois morceaux d'un coup :
docker exec -u git demo-gitea \
  gitea dump -c /data/gitea/conf/app.ini --type tar.gz --file /tmp/gitea-dump.tar.gz
À l'intérieur : le dump de la base, app.ini, le répertoire des dépôts, et les données jointes. Plusieurs options retirent ce dont vous n'avez pas besoin — --skip-repository quand les dépôts sont déjà sauvegardés autrement, --skip-log pour laisser les journaux dehors — et --tempdir déplace le répertoire de travail.
C'est l'outil le plus simple pour une petite instance, et il a trois limites qu'il faut connaître avant de l'adopter :
- la place disque. La commande assemble l'archive dans un répertoire temporaire avant de l'écrire. Il faut donc de la place pour une copie de l'instance en plus de l'instance, sur le même serveur ;
- la durée. Copier tous les dépôts et tout recompresser à chaque fois ne profite d'aucun envoi incrémental. Sur une instance qui a grossi, la fenêtre de sauvegarde finit par ne plus tenir ;
- la cohérence. La base et les dépôts ne sont pas figés au même instant. Un
git pushqui arrive pendant la copie peut se retrouver dans l'un et pas dans l'autre. La documentation de Gitea recommande d'arrêter l'instance pour un dump vraiment cohérent.
S'ajoute une conséquence pratique : l'archive est monolithique. Récupérer un seul dépôt demande de la déplier en entier.
Pour une instance qui compte, sauvegardez donc les morceaux séparément, avec les outils de chacun : le dump natif de la base d'un côté, une archive du répertoire des dépôts de l'autre. C'est ce que fait la suite.
Le script de sauvegarde
L'exemple suppose la disposition de l'image Docker, le volume de Gitea monté sur /srv/gitea : les dépôts sous /srv/gitea/git/repositories, le reste sous /srv/gitea/gitea.
#!/bin/bash
set -euo pipefail

ts=$(date +%Y%m%d_%H%M%S)
dest=s3://sauvegardes-gitea

pg_dump -h db.interne -U gitea -d gitea --no-owner --no-acl \
  | gzip > "/backups/gitea_${ts}.sql.gz"

tar -czf "/backups/repositories_${ts}.tar.gz" \
  -C /srv/gitea/git repositories

tar -czf "/backups/gitea-data_${ts}.tar.gz" \
  --exclude='gitea/indexers' --exclude='gitea/log' \
  -C /srv/gitea gitea

aws s3 cp "/backups/gitea_${ts}.sql.gz" "${dest}/postgres/"
aws s3 cp "/backups/repositories_${ts}.tar.gz" "${dest}/files/"
aws s3 cp "/backups/gitea-data_${ts}.tar.gz" "${dest}/files/"
Sans
pipefail, un dump raté ressort en succèsDans
pg_dump | gzip, le shell ne regarde que le code de sortie du dernier maillon.gzipréussit à compresser une sortie vide, donc le script rend 0 et le cron est content.set -o pipefail— inclus dans leset -euo pipefailci-dessus — fait échouer la ligne entière dès quepg_dumpéchoue. C'est la première cause de sauvegardes vides qui passent au vert pendant des mois.
--no-owner --no-acl retire du dump les propriétaires et les droits d'origine, ce qui évite de réclamer à la restauration des rôles qui n'existent que sur le serveur de production.
L'horodatage dans le nom des fichiers n'est pas décoratif : un fichier toujours écrasé au même nom ne laisse aucune chance de revenir à la veille. Pour la rétention, une règle de cycle de vie sur le bucket supprime les objets de plus de N jours sans script à maintenir.
Les trois archives sont prises l'une après l'autre, donc pas au même instant : c'est la même limite que celle de gitea dump, et elle se réduit en lançant la sauvegarde quand personne ne pousse, pas en changeant d'outil.
Restaurer une fois, à la main
Une sauvegarde n'est prouvée que restaurée. Faites-le une fois, entièrement, sur un poste jetable — c'est aussi la procédure que vous suivrez le jour où ça compte.
docker run -d --name gitea-essai \
  -e POSTGRES_PASSWORD=essai -e POSTGRES_DB=gitea postgres:16-alpine
until docker exec gitea-essai pg_isready -q; do sleep 1; done

docker exec gitea-essai psql -U postgres -c 'create role gitea'
gunzip -c /backups/gitea_20260918_010000.sql.gz \
  | docker exec -i gitea-essai psql -U postgres -v ON_ERROR_STOP=1 -d gitea

mkdir -p /essai
tar -xzf /backups/repositories_20260918_010000.tar.gz -C /essai
ON_ERROR_STOP=1 est indispensable : sans lui, psql continue après une erreur et vous finissez avec une base à moitié restaurée qui a l'air de marcher.
Le create role gitea avant le dump n'est pas un détail : un dump PostgreSQL pris sur l'instance de production porte des lignes qui nomment le rôle gitea, et elles échouent si ce rôle n'existe pas dans le conteneur jetable.
Reste la partie que la base ne peut pas prouver : un dépôt est-il réellement clonable ?
git clone /essai/repositories/demo/demo.git /essai/clone-demo
git -C /essai/clone-demo log --oneline -5
Un git clone depuis le chemin restauré fait lire à Git le HEAD, les refs et les objects du dépôt nu, puis reconstruire un arbre de travail. Le git log qui suit montre les derniers commits : c'est là, et seulement là, que vous savez que le code est revenu.
Prenez le temps que tout ça a pris. C'est votre durée de restauration réelle, la seule à comparer au délai que vous avez promis.
Ce qu'on vérifie
Côté base, le dump s'est rejoué sans erreur ne veut pas dire que les données sont là. Cinq questions :
select count(*) from information_schema.tables where table_schema = 'public';
select count(*) from repository;
select count(*) from "user";
select to_timestamp(max(updated_unix)) from repository;
select count(*) from repository r left join "user" u on u.id = r.owner_id where u.id is null;
- Le schéma est là. Zéro table, c'est un dump vide qui s'est rejoué parfaitement.
- Les dépôts sont connus. Comparez à l'ordre de grandeur de votre instance, pas à un chiffre exact.
- Les comptes sont là.
userest un mot réservé en SQL, d'où les guillemets. Une base sans compte est une base où personne ne se connectera. - L'activité est récente. La date la plus récente doit être proche d'aujourd'hui. C'est ce qui attrape un job de sauvegarde qui a cessé de tourner.
- Aucun dépôt n'est orphelin. Un dépôt dont le propriétaire a disparu est un dépôt que Gitea n'affichera à personne, alors que les deux tables sont pleines. Cette requête doit rendre zéro.
Les noms de colonnes dépendent de votre version de Gitea. Un \d repository dans la base restaurée dit ce qu'elle contient réellement.
Côté fichiers, on compte les dépôts nus présents dans l'arborescence dépliée et on les compare à ce que la base annonce :
find /essai/repositories -mindepth 2 -maxdepth 2 -type d -name '*.git' | wc -l
Deux chiffres qui ne collent pas, c'est une des deux sauvegardes qui a décroché de l'autre. Puis détruisez tout : docker rm -f gitea-essai.
Automatiser cette vérification
Ce qui précède coûte une heure ou deux, à chaque fois. C'est pour cette raison que ces tests, faits à la main, finissent par ne plus être faits.
RestoreProof rejoue exactement ces étapes en tâche planifiée, sur votre infrastructure : un runner récupère la sauvegarde, la restaure dans un conteneur jetable, pose les mêmes questions, détruit tout, et signe le résultat. Les données ne sortent pas de chez vous.
Déclarez d'abord chaque sauvegarde comme source — le bucket, le préfixe, le motif (gitea_*.sql.gz d'un côté, repositories_*.tar.gz de l'autre) et la stratégie le plus récemment modifié. Les clés d'accès ne se saisissent pas : le plan porte une référence, env://AWS_ACCESS_KEY_ID, que le runner résout dans son propre environnement. Voir les références de secrets.
Comme la sauvegarde est en deux morceaux, la vérification est en deux plans : un pour la base, un pour les dépôts. C'est le découpage que suit déjà la recette des applications auto-hébergées, et il a une raison pratique : un plan qui échoue vous dit lequel des deux morceaux est en cause, sans lecture de journal.
| À la main | Dans le plan |
|---|---|
aws s3 cp depuis le bucket | fetch, qui prend le fichier le plus récent |
gunzip -c | unpack, format gzip |
docker run postgres:16-alpine | start_sandbox |
create role gitea | fait par restore_postgres : il crée les rôles que le dump nomme |
psql -v ON_ERROR_STOP=1 | restore_postgres, format plain |
tar -xzf repositories_*.tar.gz | unpack, format tar.gz, dans le second plan |
docker rm -f | le nettoyage, toujours exécuté |
Les questions, elles, deviennent des sondes :
| À la main | La sonde |
|---|---|
select count(*) from repository | postgres, sur la table repository |
select count(*) from "user" | postgres, sur la table user |
| la jointure qui cherche les dépôts orphelins | postgres, avec l'assertion zero |
les répertoires .git attendus | filesystem-canary, sur HEAD, refs et objects |
Ce que chacune prouve : la sonde postgres se connecte à la base restaurée, compte les tables, puis compte les lignes de la table qu'on lui donne et compare au seuil avec gte, lte, eq ou zero. Une base sans aucune table fait échouer la sonde sans même regarder le seuil. La sonde filesystem-canary parcourt l'arborescence restaurée, vérifie que chaque chemin nommé existe, et applique deux planchers : un nombre de fichiers et un poids total. C'est ce dernier contrôle qui attrape une archive qui a fondu de milliers de fichiers à une poignée.
Le seul ajout est max_age, et c'est le contrôle qu'une restauration ne peut pas déduire du contenu : il fait échouer l'exécution quand la sauvegarde la plus récente trouvée à la source est plus vieille que ce délai. Les deux plans complets, prêts à coller dans l'éditeur, sont dans la recette des applications auto-hébergées.
La version du bac à sable
postgres:16-alpinedoit reprendre la version majeure de votre serveur. Un dump pris sur un serveur plus récent ne se rejoue pas sur un serveur plus ancien.
Les seuils ne se recopient pas depuis cette page. Un essai restaure votre sauvegarde, compte ce qu'elle contient réellement, et propose chaque seuil 5 % sous la valeur mesurée, avec l'opérateur gte.
Il reste à choisir une fréquence. Pour un Gitea, le critère est la fenêtre de travail perdue : les dépôts locaux de votre équipe sont autant de copies du code, mais les tickets et les demandes de fusion n'existent que dans la base. Une vérification quotidienne, placée après la sauvegarde, révèle une chaîne cassée le lendemain matin.
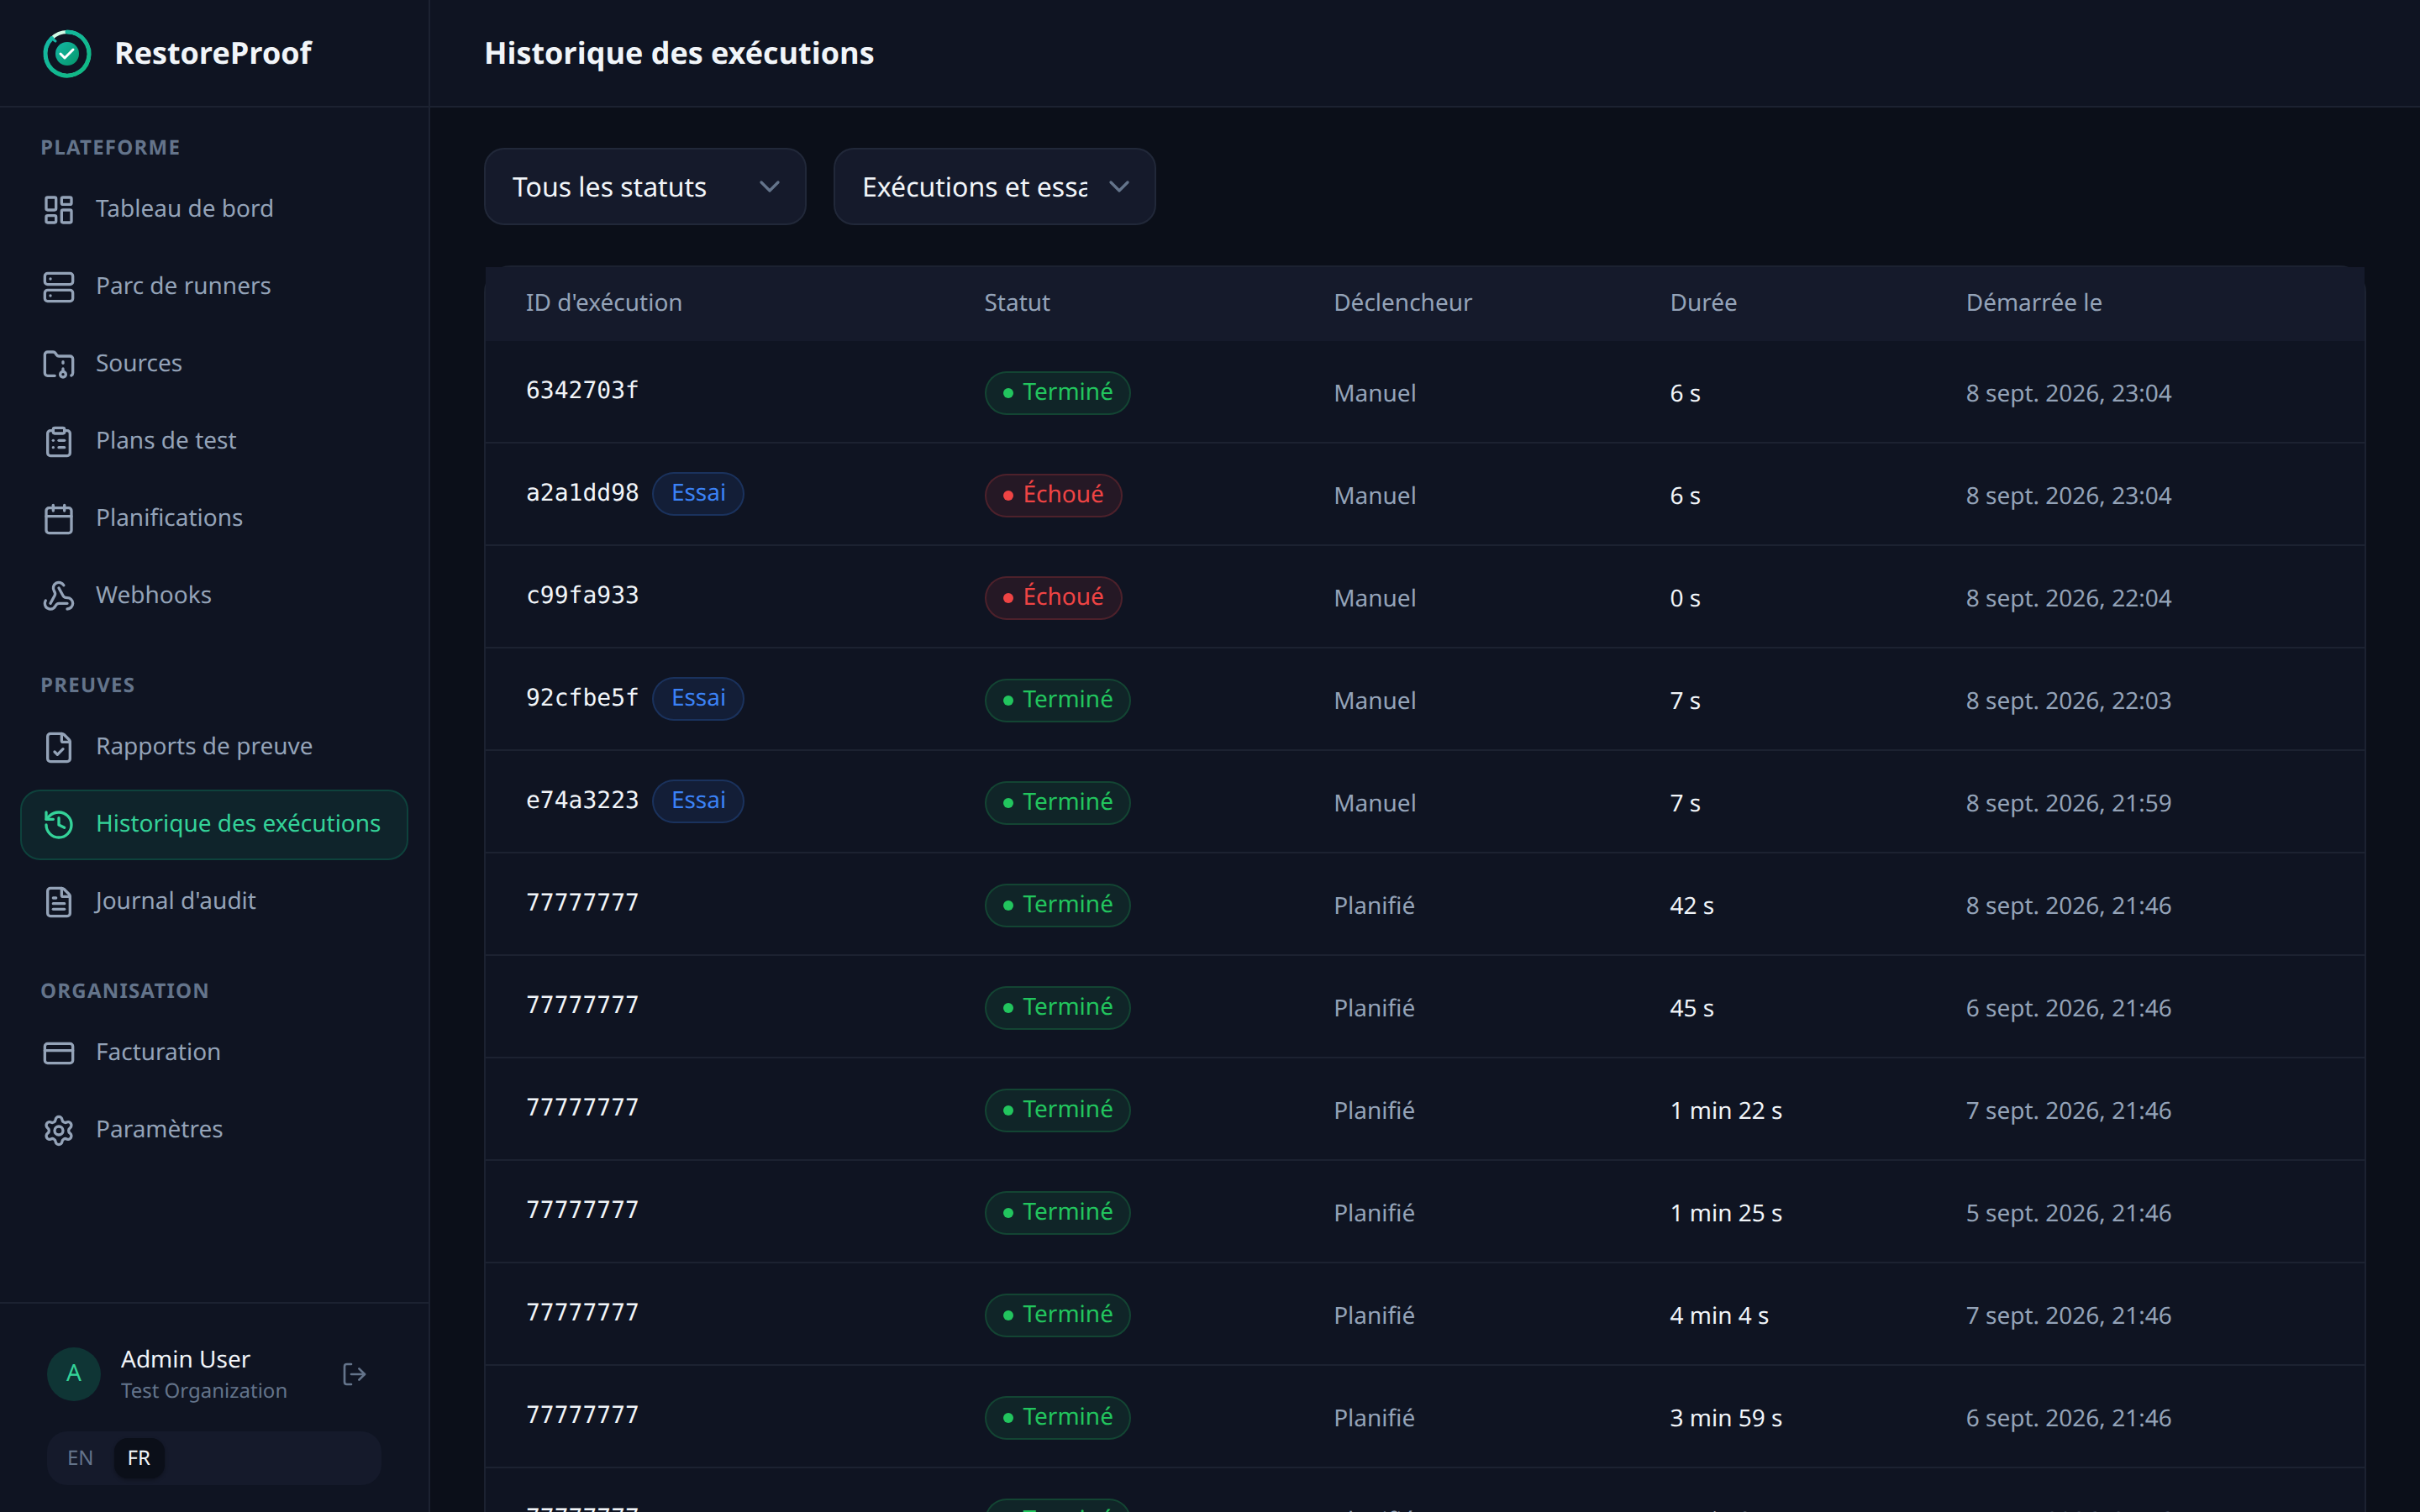
Chaque exécution laisse un rapport horodaté et signé, qui nomme la sauvegarde éprouvée et ce que chaque sonde a mesuré. L'historique montre les deux plans côte à côte, et c'est là qu'on voit lequel des deux morceaux décroche.
Ce que cette chaîne ne prouve pas
Elle prouve qu'un dump récent se restaure dans un PostgreSQL neuf, que la base restaurée décrit des dépôts rattachés à des comptes, et que l'arborescence des dépôts contient les répertoires attendus.
Elle ne prouve pas qu'un dépôt est clonable. La sonde filesystem-canary constate la présence de HEAD, refs et objects ; elle ne demande pas à Git de parcourir les objets, et un objects corrompu passerait ce contrôle. Le git clone de la restauration à la main reste la seule étape qui répond à cette question, et il n'y a pas d'étape de plan qui le rejoue.
Elle ne prouve pas non plus que Gitea redémarre sur ces données : pour cela, il faut démarrer l'application contre le bac à sable et ajouter une sonde http, comme le fait la recette pour WordPress. Enfin, elle ne dit rien de ce qui a été poussé depuis le dernier dump — cet écart, c'est votre RPO, et il se règle avec la fréquence des sauvegardes, pas avec les tests.
Éprouver ses sauvegardes sans y penser
RestoreProof rejoue ces étapes sur votre infrastructure, aussi souvent que vous le décidez : il récupère la sauvegarde, la restaure dans un conteneur jetable, pose les mêmes questions, détruit tout, et signe le résultat. Vos données ne sortent pas de votre réseau.
FAQ
Mes développeurs ont tous un clone du dépôt. Ai-je vraiment besoin d'une sauvegarde ?
Un clone contient le code et son historique, donc la perte du serveur ne perd pas le code. Elle perd tout le reste : les tickets, les demandes de fusion et leurs revues, les étiquettes, les jalons, les droits d'accès, les webhooks, les jetons de vos chaînes d'intégration. Rien de tout cela n'est dans un clone, et c'est ce que contient la base de données.
gitea dump suffit-il ?
Pour une petite instance, oui. Il assemble les trois morceaux dans une seule archive. Ses limites sont la place disque — il fabrique une copie complète avant d'écrire l'archive —, la durée, qui grandit avec l'instance sans envoi incrémental possible, et le fait que la base et les dépôts ne sont pas figés au même instant.
Que perd-on en oubliant app.ini ?
La restauration se fait, mais app.ini porte le SECRET_KEY avec lequel Gitea a chiffré certaines valeurs enregistrées en base : les secrets de double authentification, les mots de passe des miroirs, les secrets des applications OAuth. Sans ce fichier, ces valeurs sont illisibles, même avec une base parfaitement restaurée.
Comment vérifier qu'un dépôt restauré est réellement utilisable ?
En le clonant depuis le chemin restauré, puis en lisant son journal. Git lit alors HEAD, les refs et les objects, et reconstruit un arbre de travail. La présence des répertoires attendus, elle, ne prouve que la présence.
Un dépôt qui utilise LFS se restaure-t-il avec le reste ?
Seulement si l'archive des données de Gitea est là. Les objets LFS ne sont pas dans les dépôts nus : ils vivent sous /data/gitea, avec app.ini, les avatars et les pièces jointes. Un dépôt LFS restauré sans eux se clone, mais ne revient pas complet : les fichiers suivis par LFS manquent.